
 IXThinker·2025-01-31 00:40
DeepSeek-V3低成本煉成 不靠堆算力靠優化
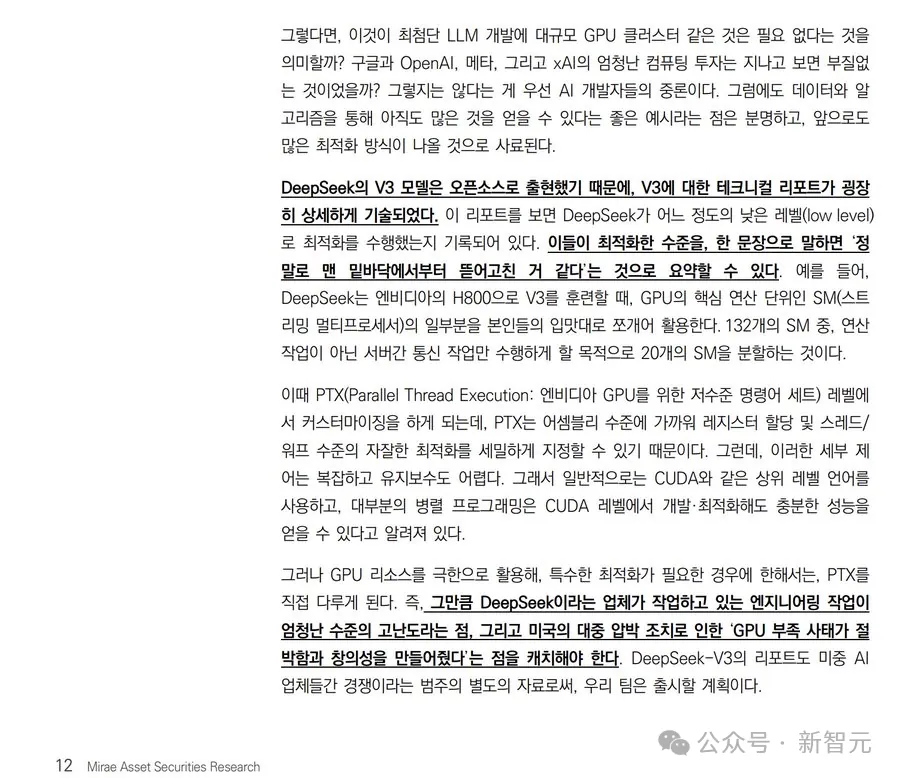
DeepSeek-V3與R1以極低成本取得比肩OpenAI同類模型的性能,背後是一條「不堆算力、改堆優化」的路線:大量細粒度工程優化,加上直達底層的PTX編程。
驚人效率
據披露數字,團隊在2048個H800 GPU集群上,僅用兩個月便訓出6710億參數的MoE語言模型,訓練效率較頂尖AI高出約10倍,成本優勢極為醒目。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。