
 IXThinker·2025-02-25 11:00
從MLA架構看DeepSeek的降本之路
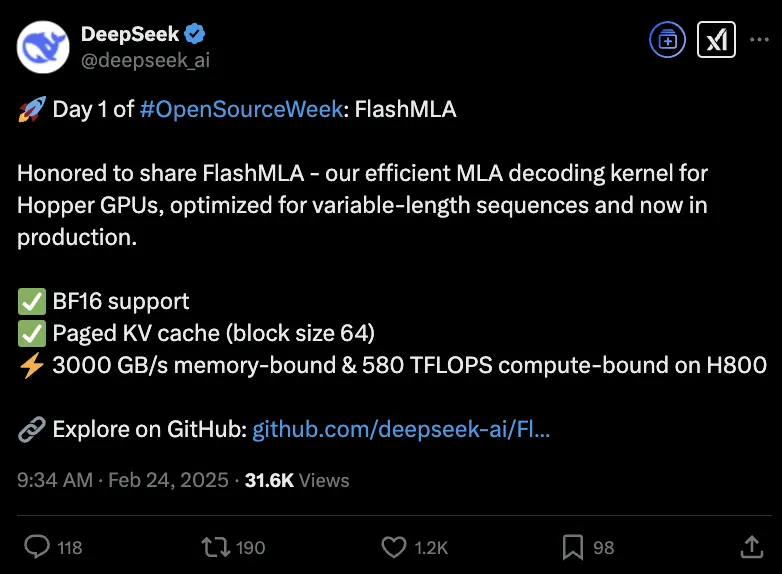
被網民戲稱為源神的DeepSeek,在開源周首日公開降本大法FlashMLA,直接突破H800的計算上限。MLA正是其自V2起沿用至今的創新注意力架構,也是成本大減的秘密所在。
MLA淵源
MLA由DeepSeek提出,自V2版本開始用於系列模型,在大幅降低成本的同時,計算與推理性能仍能與頂尖模型持平,成為其架構層面最受矚目的創新之一。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。