
 IXThinker·2025-03-10 19:00
魔搭開源GRPO全流程工具鏈 支援多模態訓練
DeepSeek-R1帶火了GRPO算法,也帶動訓練工具鏈的競爭。魔搭社區ModelScope推出新的開源全流程方案,主攻訓練速度、易用性與多模態擴展能力,降低開發者使用強化學習的門檻。
GRPO為何受關注
GRPO是PPO算法的改進版,利用採樣原理對value model進行簡化,以提升訓練的穩定性與可維護性。隨著DeepSeek-R1成功出圈,這一算法受到業界廣泛關注。
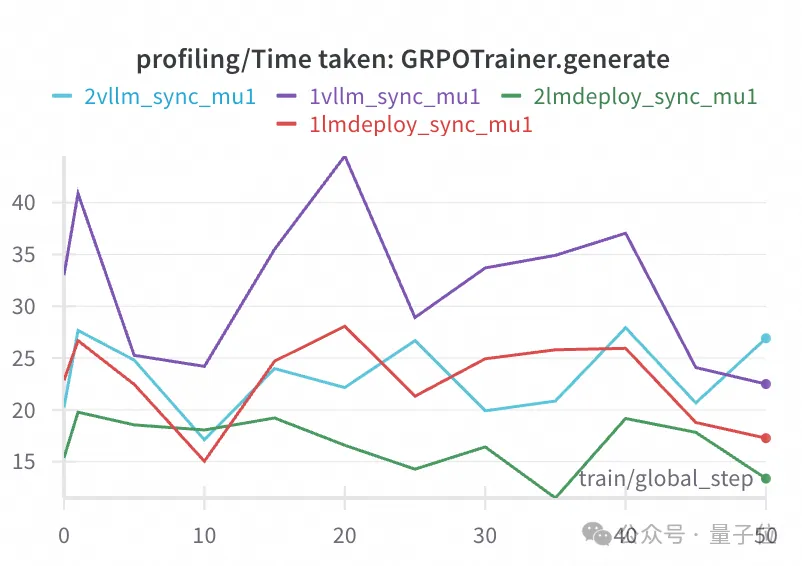
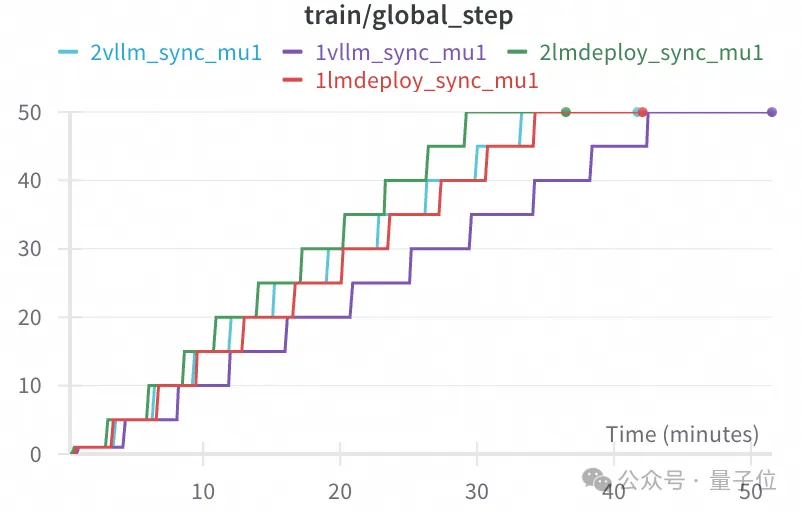
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。