
 IXThinker·2025-03-11 13:20
VLA基礎模型Magma UI導航機械操作全能
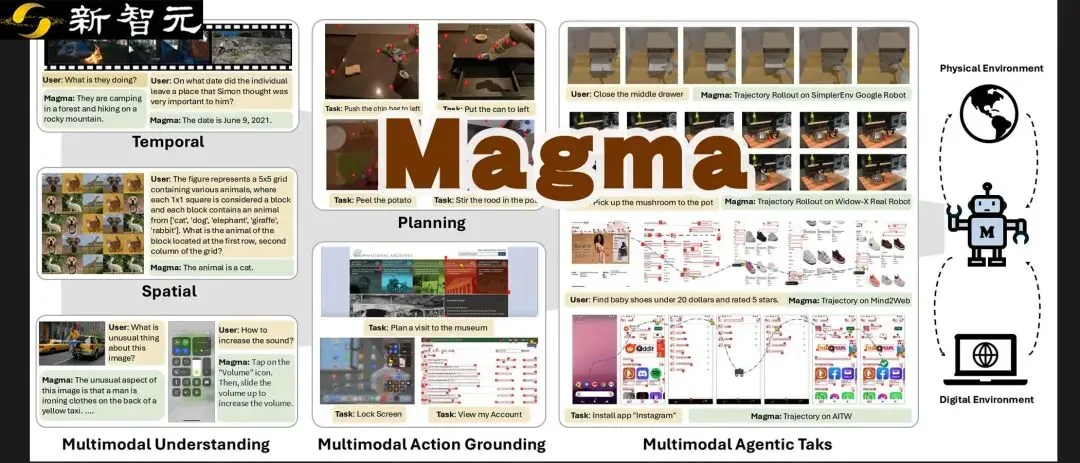
現有大語言模型、圖像生成模型大多只在某幾個模態上操作,無法像人類一樣與物理世界交互。新型多模態基礎模型Magma填補這一空隙:它面向數字與物理環境,透過視覺-語言-行動(VLA)整合,實現UI導航與機械人操作全能。
VLA是甚麼
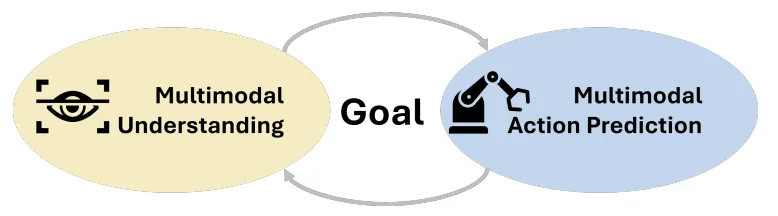
視覺-語言-行動(VLA)模型是能夠感知視覺刺激、語言輸入及其他環境相關數據的自主智能體,可在物理和數字環境中生成有意義的「具身行動」。Magma正是這一類別中的最新基礎模型。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。