
 IXThinker·2025-03-12 19:11
Unsloth新優化 GRPO訓練顯存僅需5GB
開源微調工具Unsloth在短短兩周內再次優化DeepSeek-R1同款的GRPO訓練算法,令舊款顯示卡也能訓練推理模型,上下文更長、顯存需求更省。
顯存一降再降
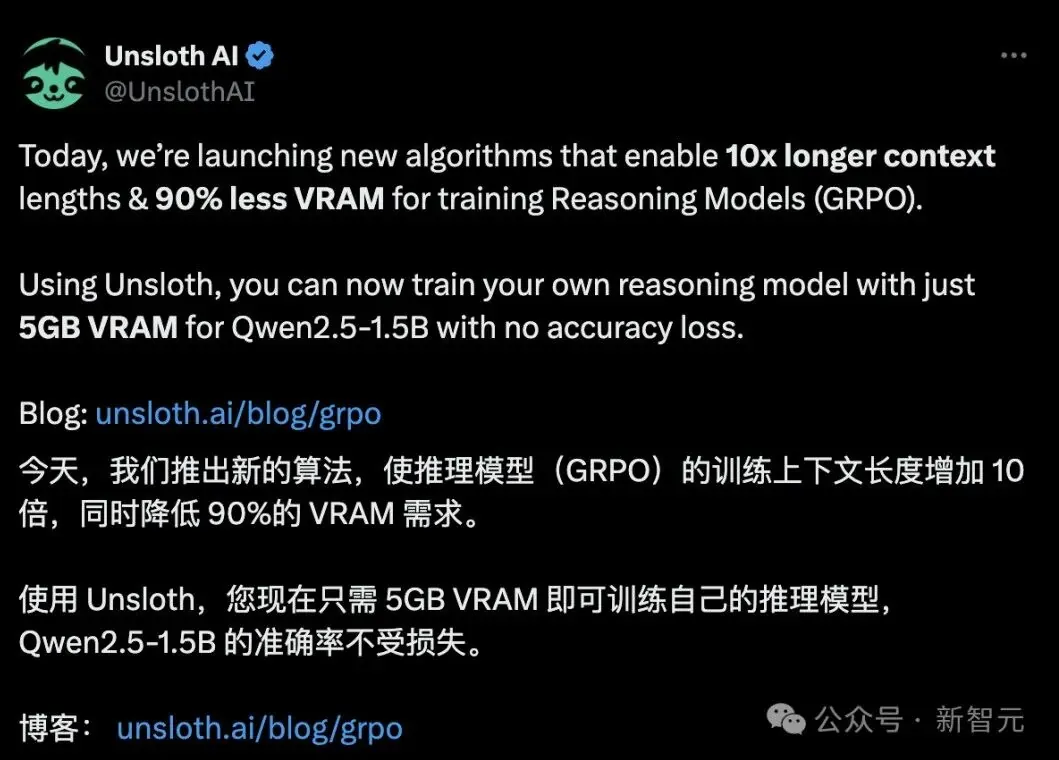
上次更新已將GRPO所需記憶體降至7GB,今次進一步減至只需5GB VRAM,即可訓練Qwen2.5(1.5B)等推理模型,較之前再節省2GB顯存。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。