
 IXThinker·2025-03-12 13:50
字節開源COMET MoE訓練成本省40%
字節豆包大模型團隊在GitHub開源MoE優化技術COMET,再度下調模型訓練成本,最高可節省40%。該技術已應用於字節的萬卡訓練集群,在真實生產環境中累計節省數百萬GPU小時,是繼UltraMem之後又一次成本優化。
通信開銷痛點
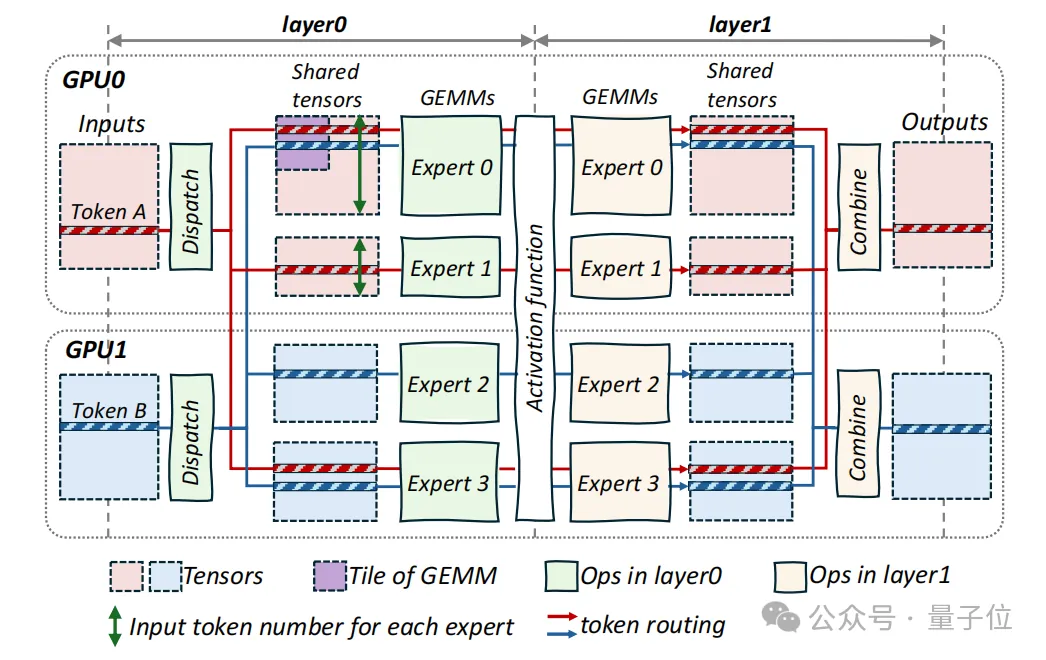
MoE模型在分布式訓練中仍存在大量通信開銷,拖累資源利用率。COMET內部透過一套細粒度計算-通信折疊技術,結合GPU資源優化,針對性削減這部分損耗,從而將訓練成本最多降低40%。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。