
 IXThinker·2025-06-28 22:20
Jina發布V4向量模型 38億參數多模態多語言
檢索增強生成與智能體應用對底層向量模型的要求越來越高。Jina正式發布jina-embeddings-v4,以38億參數同時處理文本與圖像,主打「為搜索而生」的多模態多語言能力。
模型規模
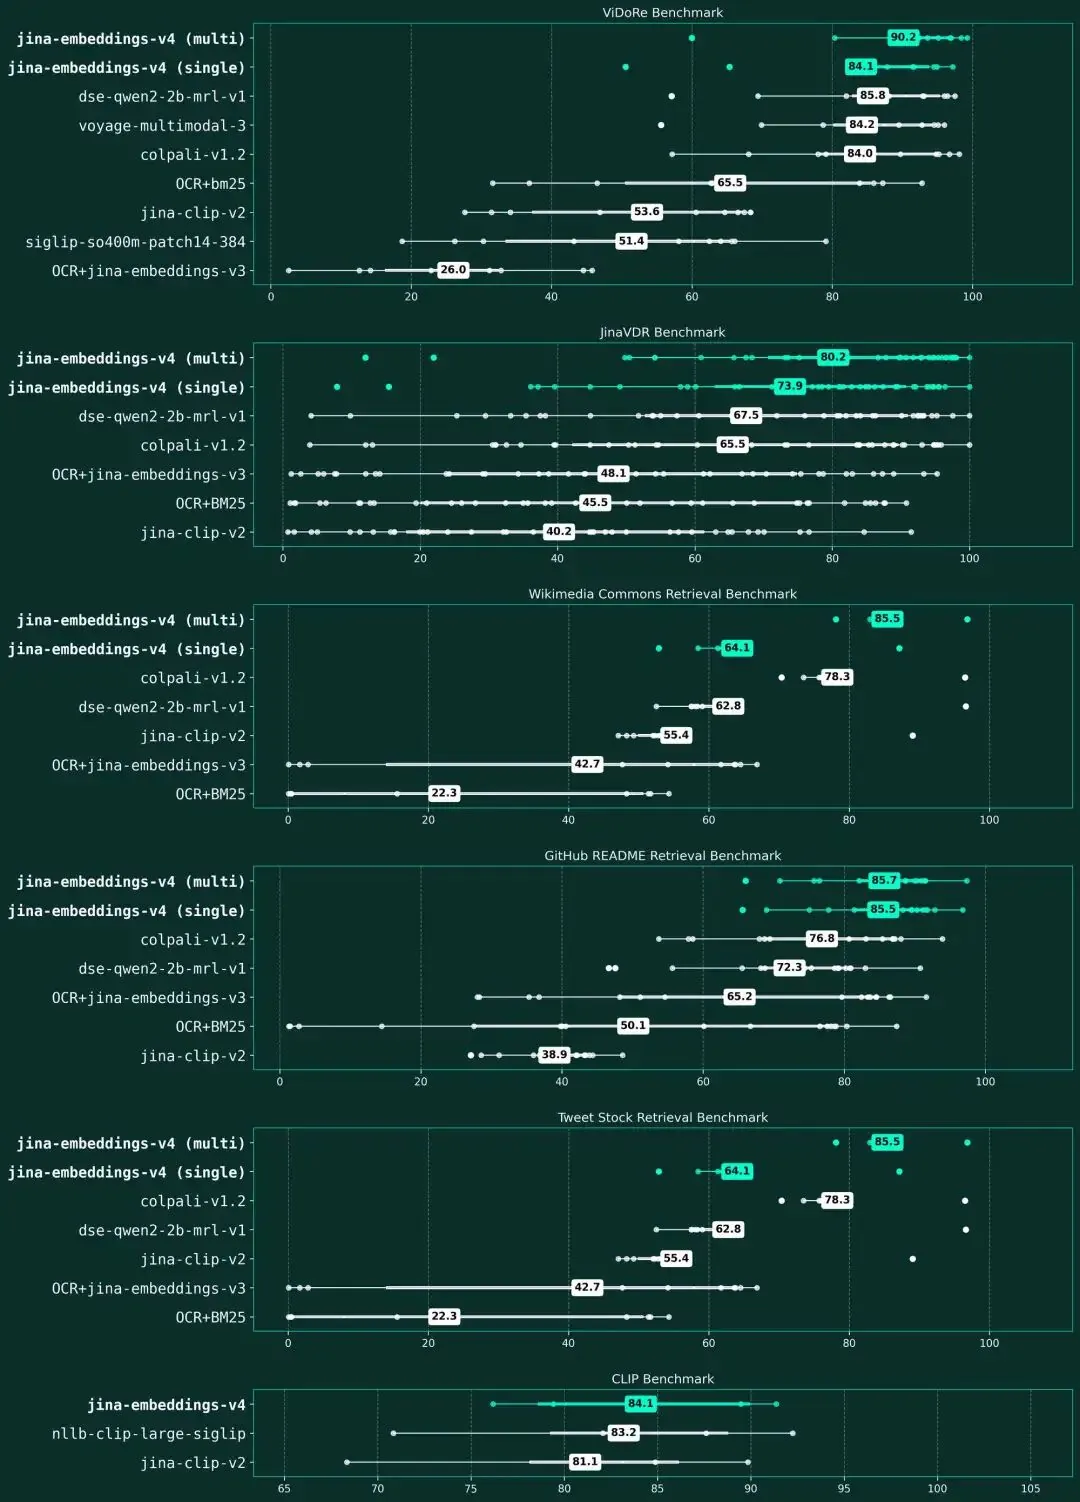
jina-embeddings-v4參數規模達38億,並首次實現對文本與圖像的同步處理。無論表格、圖表還是複雜示意圖,模型都能精準解讀其中資訊,特別擅長富含視覺內容的檢索場景。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。