
 IXThinker·2025-07-17 10:52
大模型架構之戰:MoE憑效率成主流路線
大語言模型的參數規模在數年間由百億級膨脹至萬億級,架構亦由傳統稠密模型轉向稀疏MoE。從GPT-2到Llama 4,OpenAI、Meta、Mistral與DeepSeek等玩家在閉源與開源之間競逐,模型進化速度前所未見。
參數大躍進
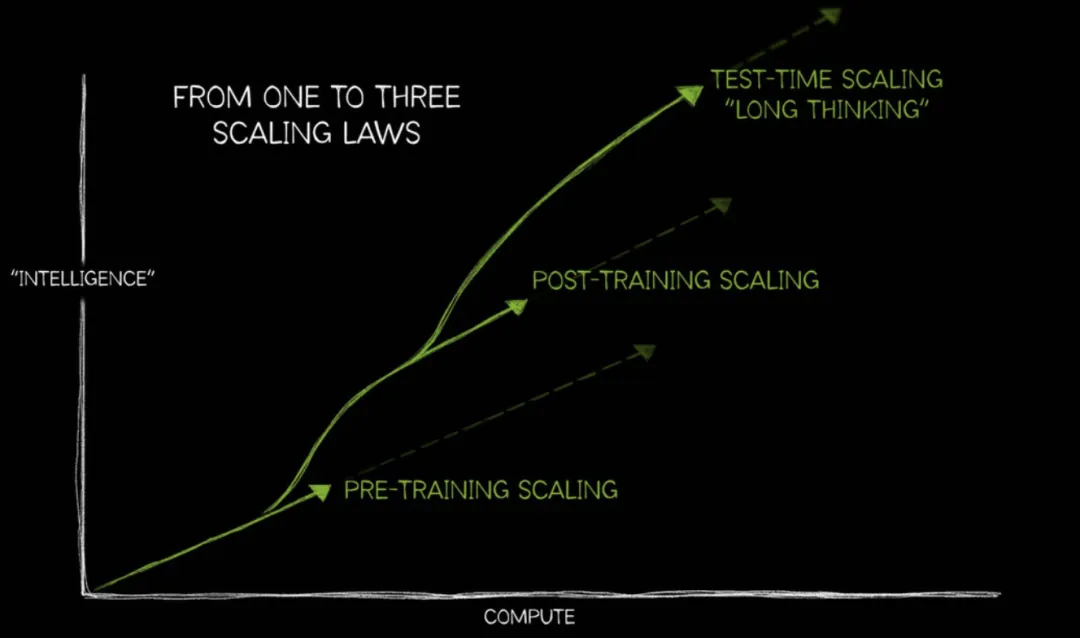
自2019年GPT-2發布以來,大語言模型在參數規模、訓練數據量與架構上不斷躍升。最初參數量僅百億級,如今即使只計激活參數也達數百億,背後是業界對Scaling Law的持續押注與信仰。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。