
 IXThinker·2025-08-17 11:00
Meta開源DINOv3:7B參數視覺模型 自監督學習創新高
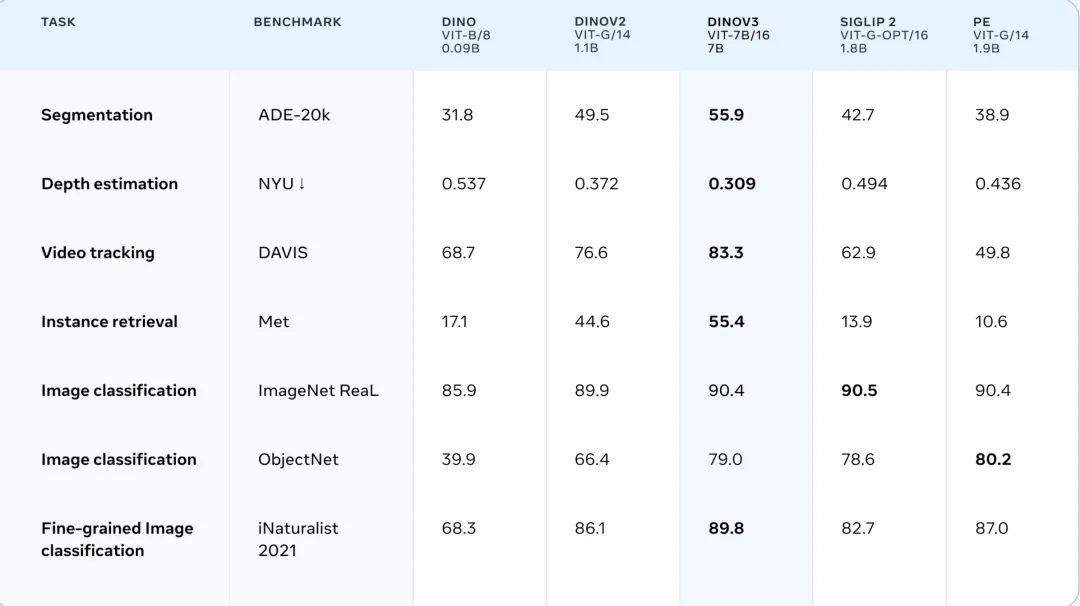
Meta發布開源視覺模型DINOv3,首次證明自監督學習模型可在廣泛任務中超越弱監督學習,模型規模達70億參數,訓練數據涵蓋17億張圖像,在三大核心視覺任務上實現SOTA。
發布消息概況
Meta近日正式開源全新視覺模型DINOv3,此舉被視為該公司在計算機視覺領域的重大動作,發布消息迅速在技術社群引發熱烈討論。
該模型採用無標註的自監督方法訓練,能夠高效支持數據標註稀缺、成本高昂或無法獲取的應用場景,為業界提供了嶄新的技術選擇。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。