
 IXThinker·2025-09-14 00:10
Qwen3-Next以一成算力練長文利器
AI狂飆之下,閉源大模型堅信「越大越強」,但一只80B的開源「小鋼炮」給出另一個答案。Qwen3-Next以極稀疏MoE與混合注意力,把單次激活參數壓至約3B,訓練成本約十分之一,在推理與長文場景表現突出。
極稀疏激活設計
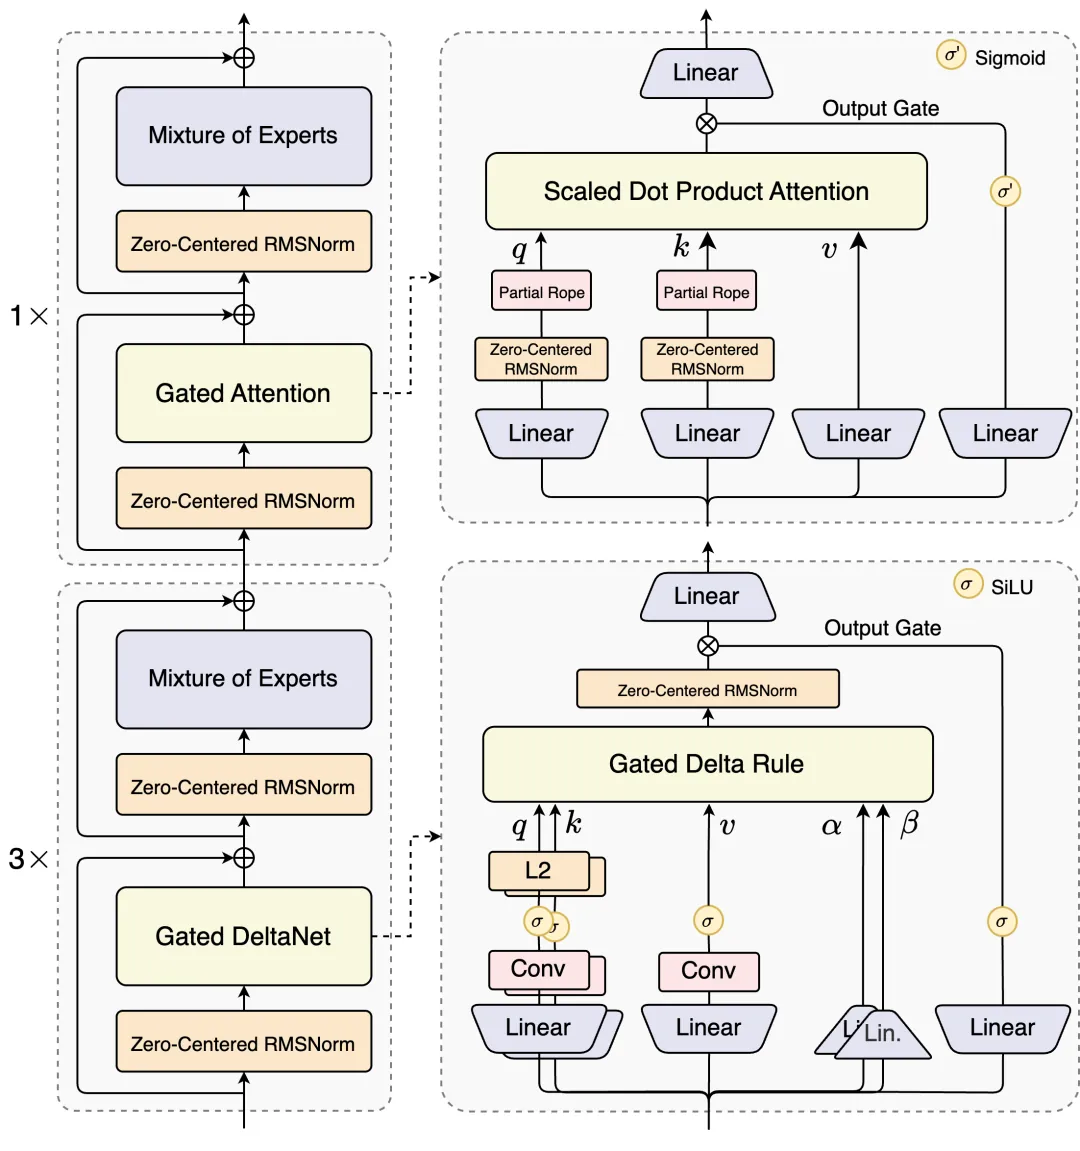
Qwen3-Next 80B每次前向只激活約3B參數,配合混合注意力機制,大幅降低訓練與推理成本。官方數據顯示,其訓練成本約為同級路線的十分之一。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。