
 IXThinker·2025-09-28 12:30
開源RL訓練框架登場 兩次實驗結果完全重合
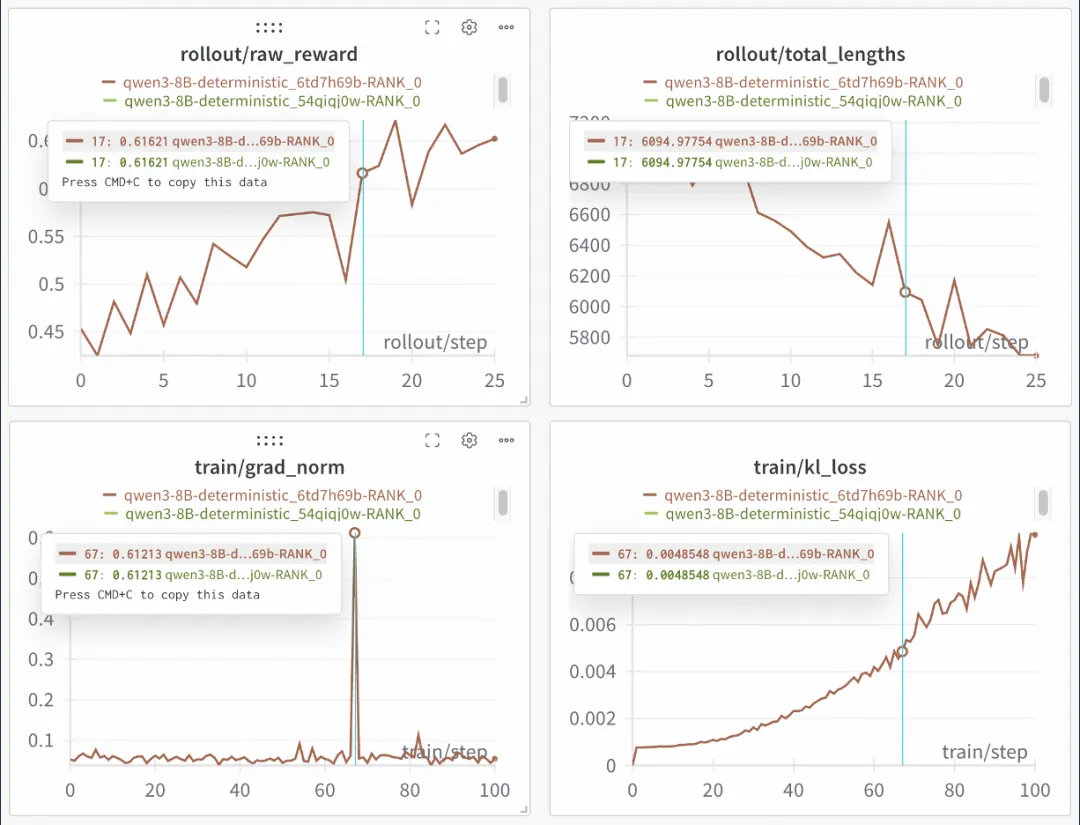
強化學習訓練結果難以復現,是業界長期痛點。SGLang團隊聯合slime團隊推出開源框架,實現100%可復現的穩定RL訓練:基於Qwen3-8B的兩次重複實驗,結果完全重合。
完美重合
在基於Qwen3-8B的重複實驗中,該框架兩次運行的訓練曲線完全重合成一條,達成結果的完美重合。這為需要高精度復現的實驗場景提供了可靠保障,也令結果核對變得可信。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。