
 IXThinker·2025-12-13 19:40
Jina-VLM:手提電腦可跑的多語言視覺模型
小參數視覺語言模型常有「顧此失彼」的難題:增強視覺能力就犧牲文本表現,高分辨率推理成本亦高。新發布的Jina-VLM針對這兩點給出自己的解法,並強調硬件門檻極低。
架構設計
Jina-VLM只有2.4B參數,引入注意力池化機制,連接SigLIP2視覺編碼器與Qwen3語言基座,在支持29種語言的同時平衡視覺與語言能力,避免小模型常見的能力此消彼長,並在同等規模下取得多語言視覺問答的SOTA成績。
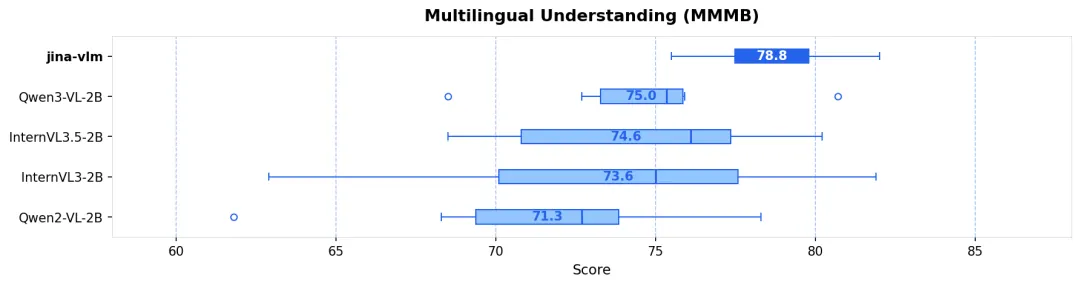
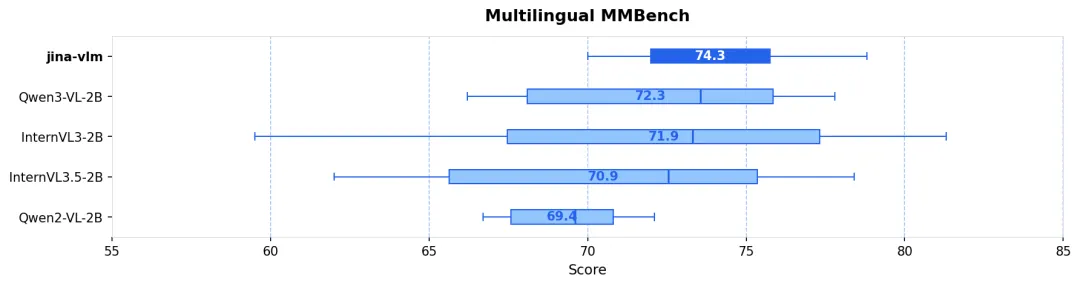
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。