
 IXThinker·2026-04-08 14:46
三秒聲音克隆 開源語音模型多語言配音
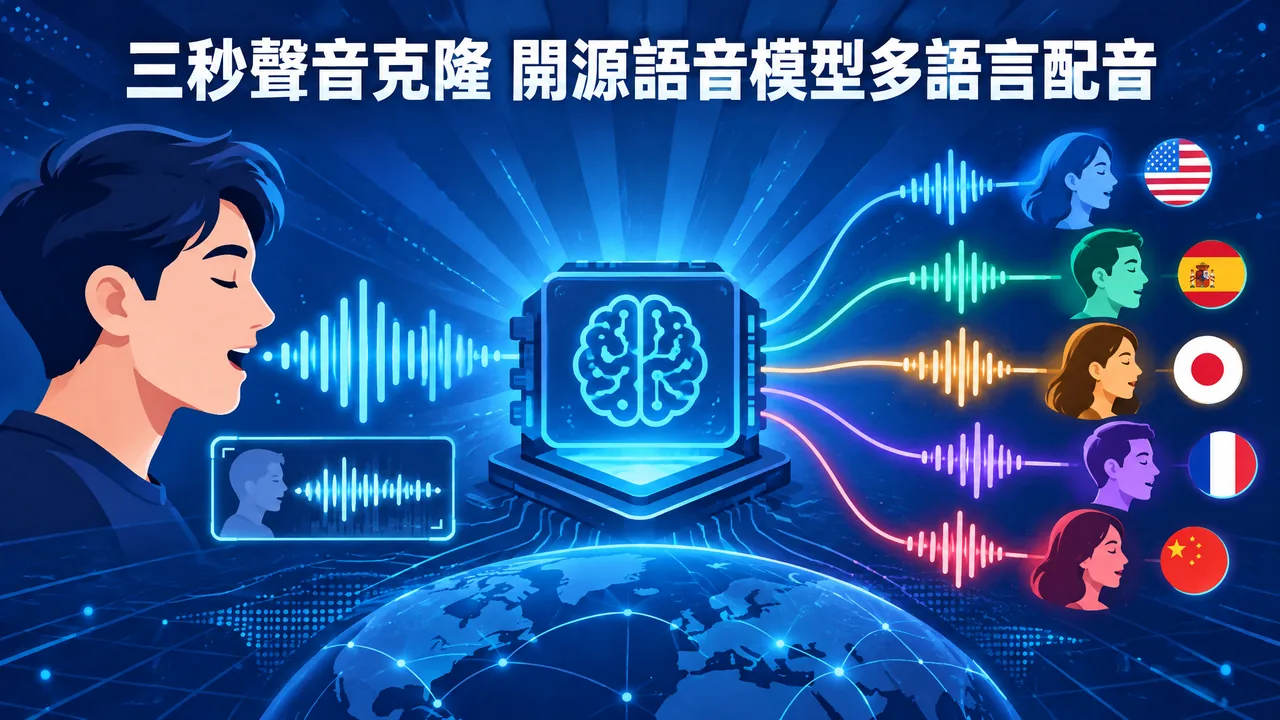
Mistral開源語音模型Voxtral-4B,採混合架構生成語義與聲學兩類token:語義部分經語音識別蒸餾對齊文本,聲學部分在連續空間高效生成;僅需約三秒參考語音,即可克隆高質量多語言聲線。
混合架構解難題
輕量級語音模型長期難以兼顧多語言自然度與部署效率。新模型以Voxtral Codec把語音編碼為語義與聲學兩類token:語義部分自回歸生成以保障長文一致性,聲學部分由流匹配模型在連續空間產出,質量與效率並重。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。