
 IXThinker·2026-04-09 15:10
三秒聲音樣本即克隆 開源語音模型
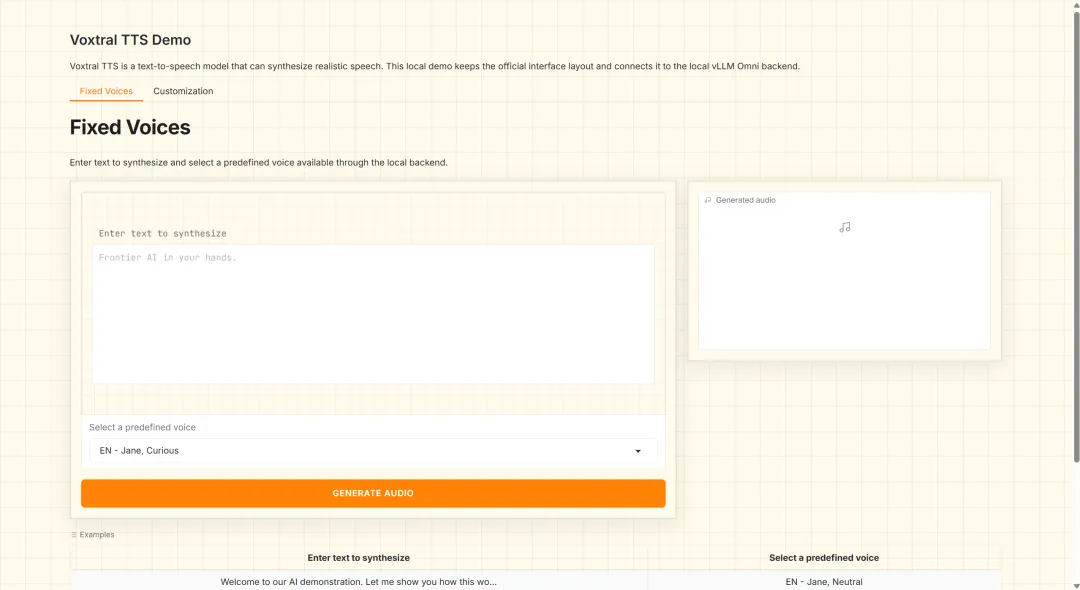
有歐洲公司開源語音合成模型 Voxtral 新作,僅需三秒音頻樣本即可克隆音色,以四十億參數兼顧自然度與部署效率,採量化方案對齊語義與聽感,適用邊緣設備與實時互動場景。
三秒即克隆音色
模型具備強大的零樣本克隆能力,僅憑三秒音頻樣本即可復現說話者音色,實現「配音自由」,對語音智能體與內容播報等需要高度語言理解的場景尤為實用。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。