
 IXThinker·2026-04-18 11:20
小米開源600種語言語音模型OmniVoice
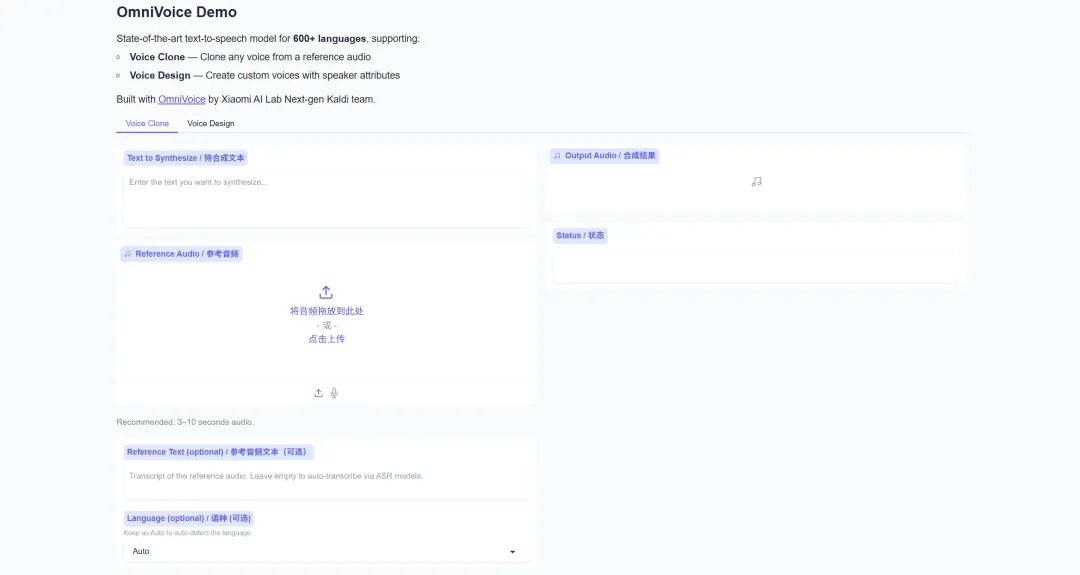
小米人工智能實驗室推出並開源支援逾六百種語言的零樣本文字轉語音模型OmniVoice,採用單階段離散非自回歸架構,直接將文本映射為聲學標記,全部基於五十八萬小時開源數據訓練,惠及低資源語言。
語言覆蓋創紀錄
現有零樣本文字轉語音模型通常只支援少數語言,大量低資源語言被忽略。新模型將支援語言數量提升至六百種以上,實現迄今最廣泛的語言覆蓋,對服務少數語言用戶與文化保育具實際意義。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。