
 IXThinker·2026-04-25 17:30
谷歌發布Vision Banana 刷新多項視覺SOTA
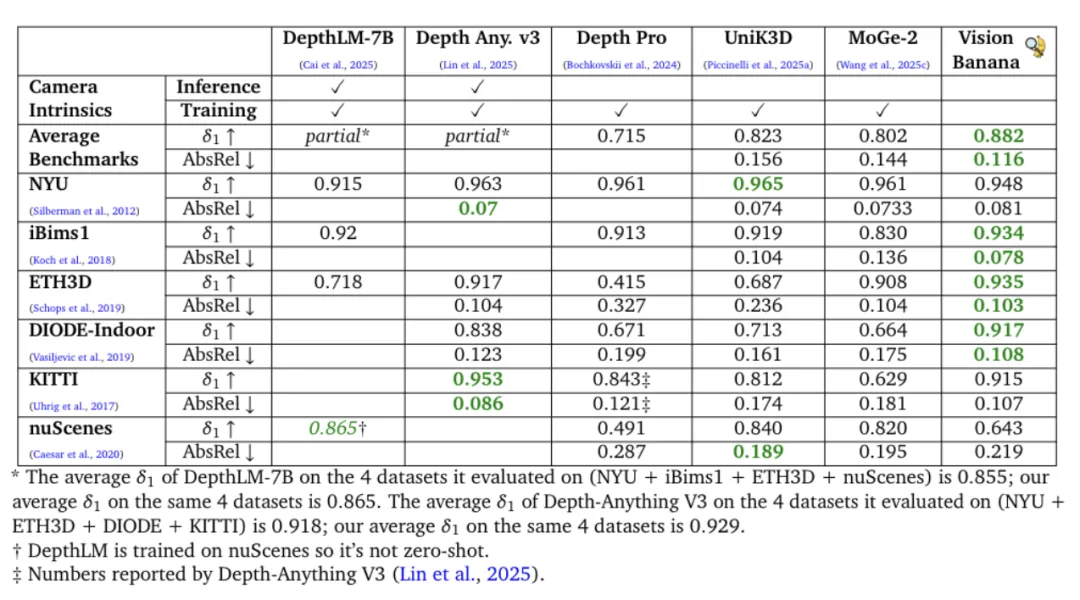
谷歌 DeepMind 推出通用視覺模型 Vision Banana,何愷明、謝賽寧等參與。模型以圖像生成預訓練為統一範式,零樣本即在分割、深度等任務超越 SAM 3,刷新多項 SOTA。
發布與團隊背景
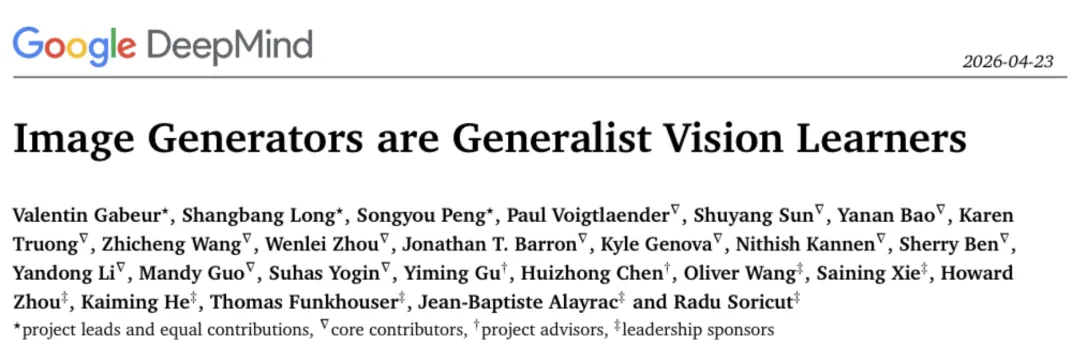
谷歌 DeepMind 最新發布通用多模態視覺大模型 Vision Banana,以 Nano Banana Pro 為底座。ResNet 作者何愷明與紐約大學教授謝賽寧等知名學者參與其中,陣容備受矚目。
模型的核心主張是:圖像生成預訓練可以成為通用視覺學習的統一範式,正如文本生成統一了各類 NLP 任務,視覺領域或將迎來自己的 LLM 時刻。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。