
 IXThinker·2026-06-16 14:20
開源音頻模型四步出聲 單卡0.24秒
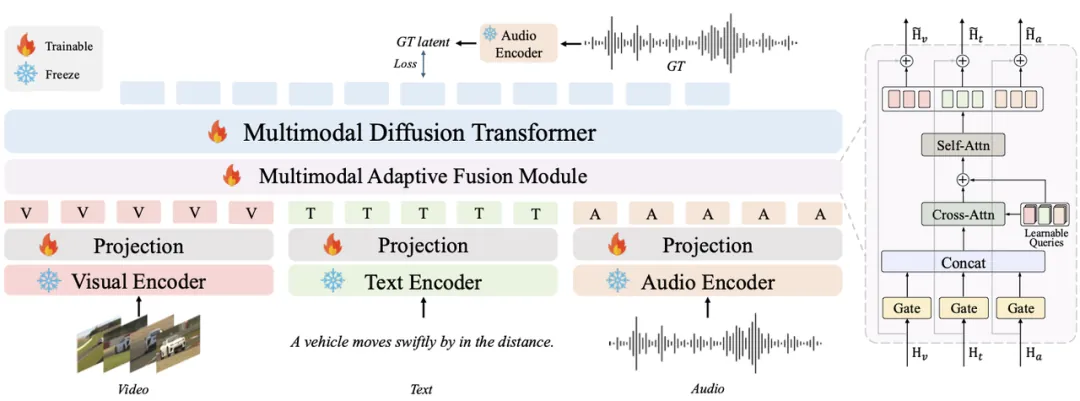
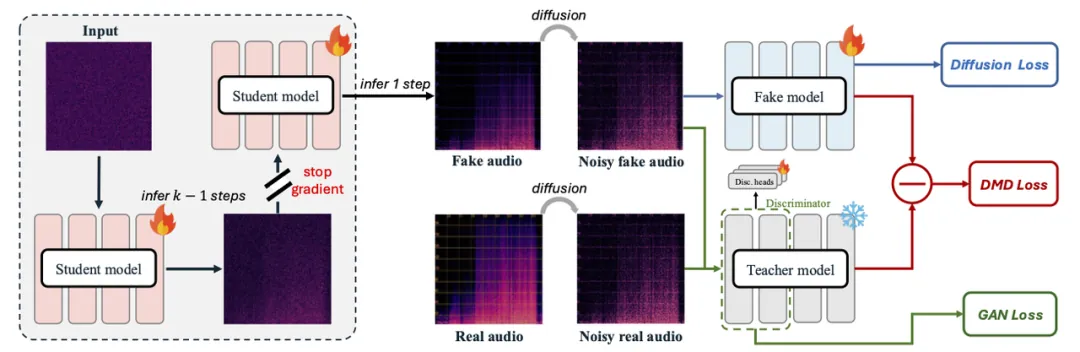
現有音頻生成模型普遍存在指令理解不準、生成速度慢兩大痛點,制約其在專業工作流與實時交互中的應用。有初創聯合多間大學推出開源音頻大模型,主打跨模態輸入與極速推理,單卡可在零點二四秒內生成音頻。
行業兩大痛點
對文字指令的理解偏差,是現有音頻模型的通病,例如混淆聲音出現的順序或數量;同時生成速度慢,十秒音頻往往要等數秒甚至十多秒。這兩大問題令人工智能音頻難以從實驗工具走向專業工作流與實時交互場景。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。