
 IXThinker·2026-06-24 21:00
百度開源OCR一口氣讀完幾十頁
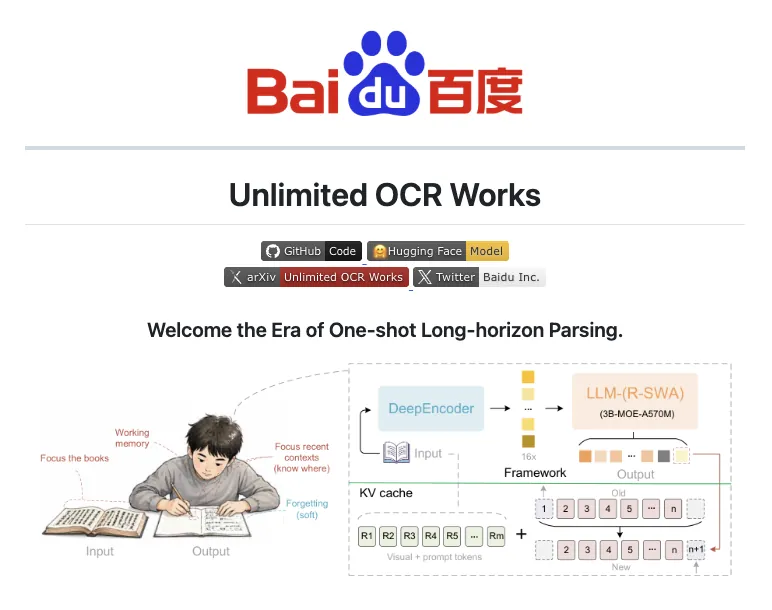
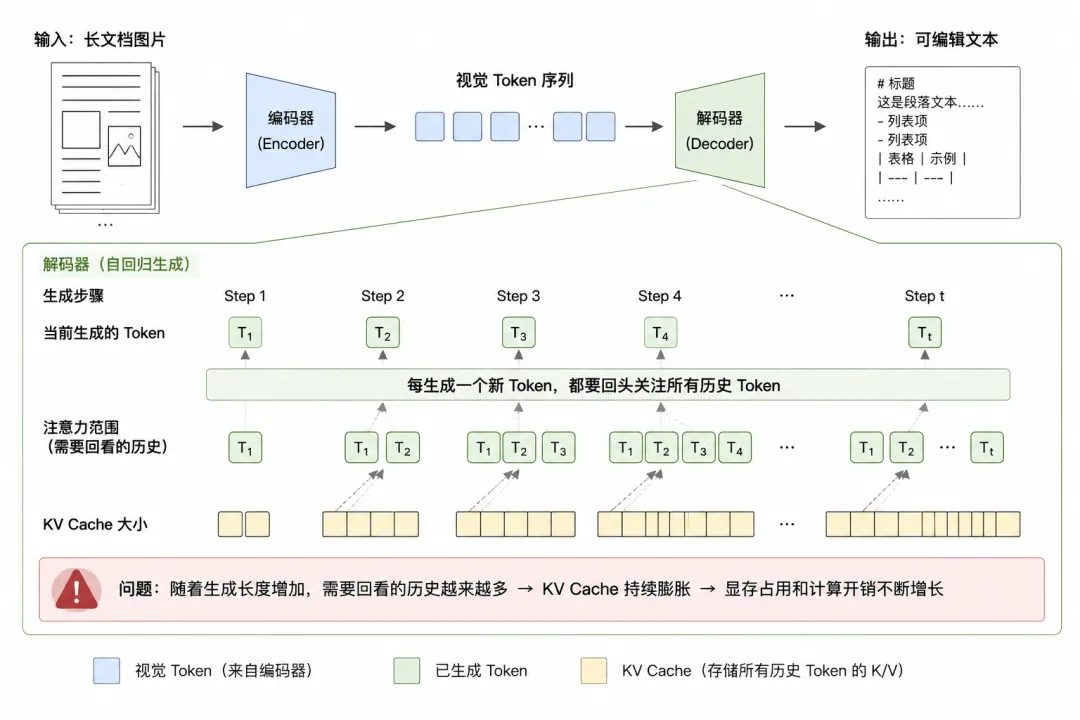
百度開源新模型Unlimited OCR,於文檔解析基準OmniDocBench刷新最佳成績。它突破逐頁識別再拼接的傳統範式,模仿人類抄錄員方式,可端到端一次處理幾十頁長文檔,連貫性顯著提升。
刷新基準最佳成績
國產開源光學字符識別再傳捷報:百度開源新模型Unlimited OCR,主打一口氣讀完幾十頁長文檔,並在文檔解析基準OmniDocBench上刷新最佳成績,整體表現超越此前同類開源模型,展現強勁實力。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。