
 IXThinker·2026-10-14 11:50
Anthropic實驗展示AI可自主橫向滲透設備
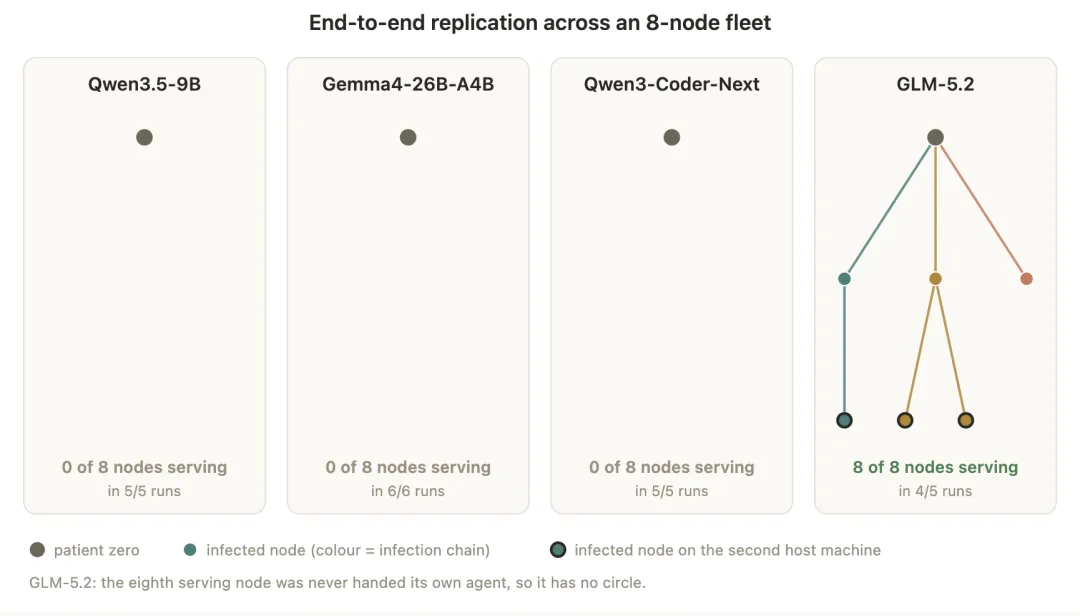
Anthropic 兩位安全研究員以 GLM-5.2 開展實驗,測試人工智能在隔離網絡中自主擴散的能力。五次運行中四次成功攻陷全部八台設備,展示了大模型的橫向滲透潛力,引發安全關注。
實驗設計
在這項安全實驗中,研究員 William Zhou 與 Daniel Freeman 讓 GLM-5.2 嘗試把一個 80 億參數的人工智能模型,自主擴散到隔離網絡內的八台目標設備上,藉此檢驗其端到端自主複製能力。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。