IXThinker·2026-10-22 18:30
JEV-27B-VL視覺語言模型在線教程上線
AutoTrust 發布視覺語言模型 JEV-27B-VL,以 Qwen3.8-27B 為基礎,針對商品分類、內容審核、封面篩選等判斷型任務優化。模型採用雙系統架構,可按需要在快速決策與深度推理之間切換,直接輸出結構化結果。
判斷型任務定位
視覺語言模型已能理解圖片並回答問題,但商品分類、內容審核、封面篩選等場景真正需要的往往只是一個明確判斷,而非冗長的文字生成。JEV-27B-VL 正是針對這類需求設計。
此類任務在電商、平台治理與媒體營運中需求龐大,若每次判斷都伴隨大段文本輸出,推理成本與回應延遲都會明顯上升,判斷結果反而被淹沒在生成內容之中。
雙系統架構
模型沿用雙系統設計思路:遇到簡單任務時以快速決策模式直接給出結論,遇到複雜情況則切換至深度推理模式展開分析,兩種模式按需調用,避免不必要的算力消耗。
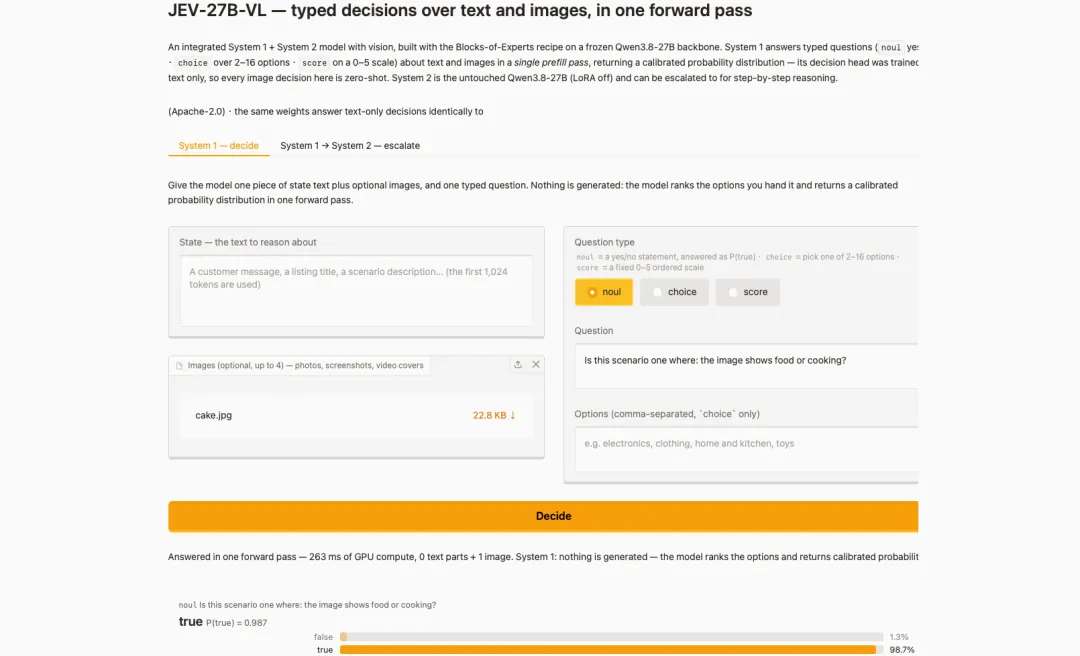
輸出形式上,模型不僅給出判斷結論,還附帶經過校準的機率值,方便下游系統設定閾值、處理邊界情況,也令判斷結果更容易嵌入現有的自動化流程。
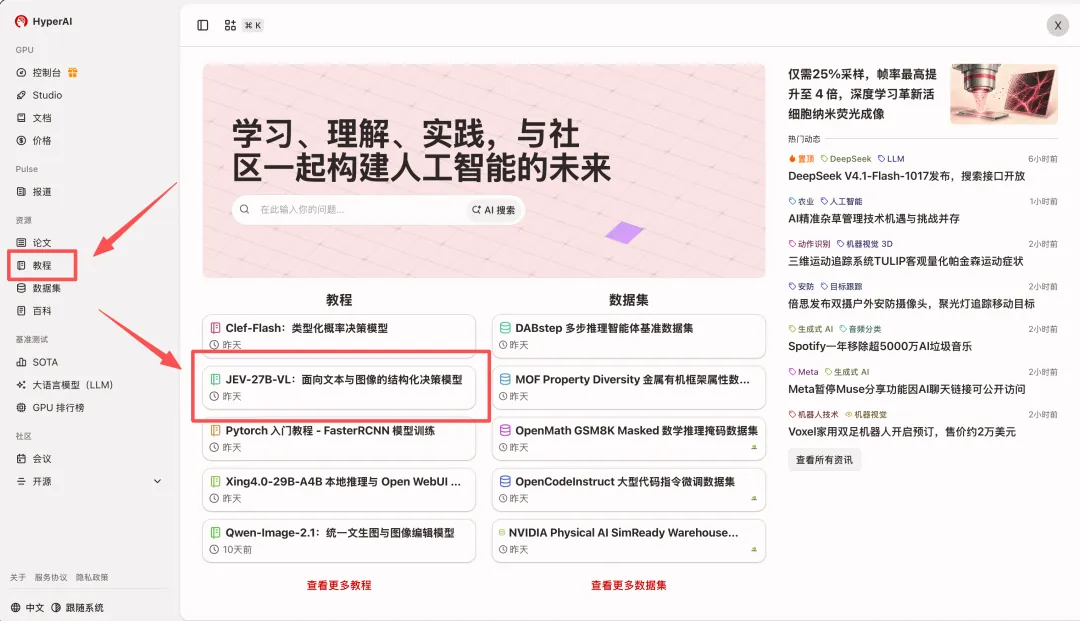
教程與體驗
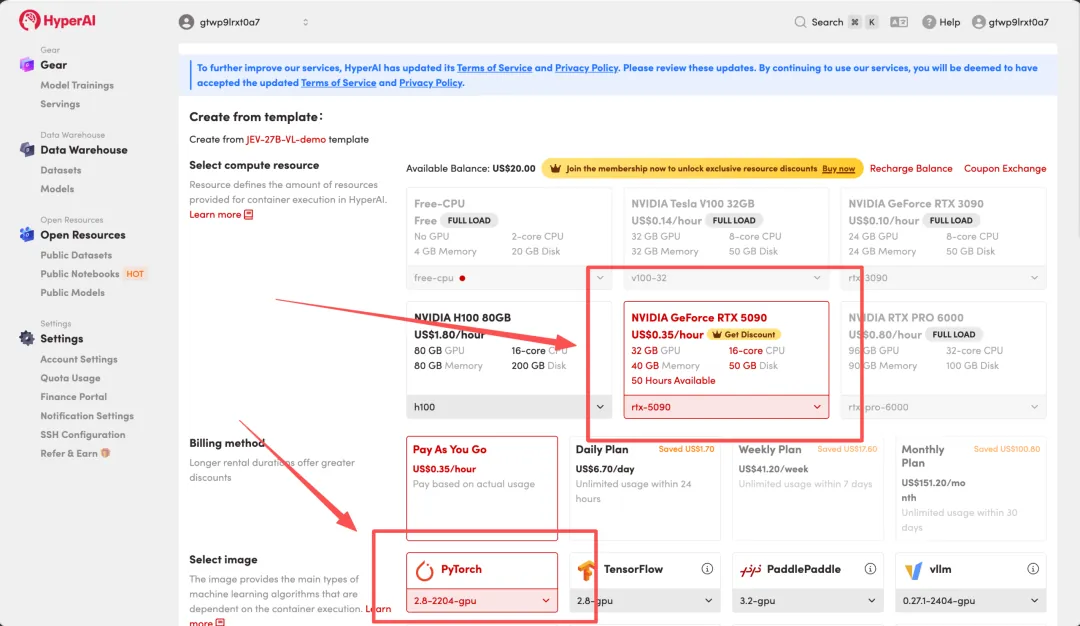
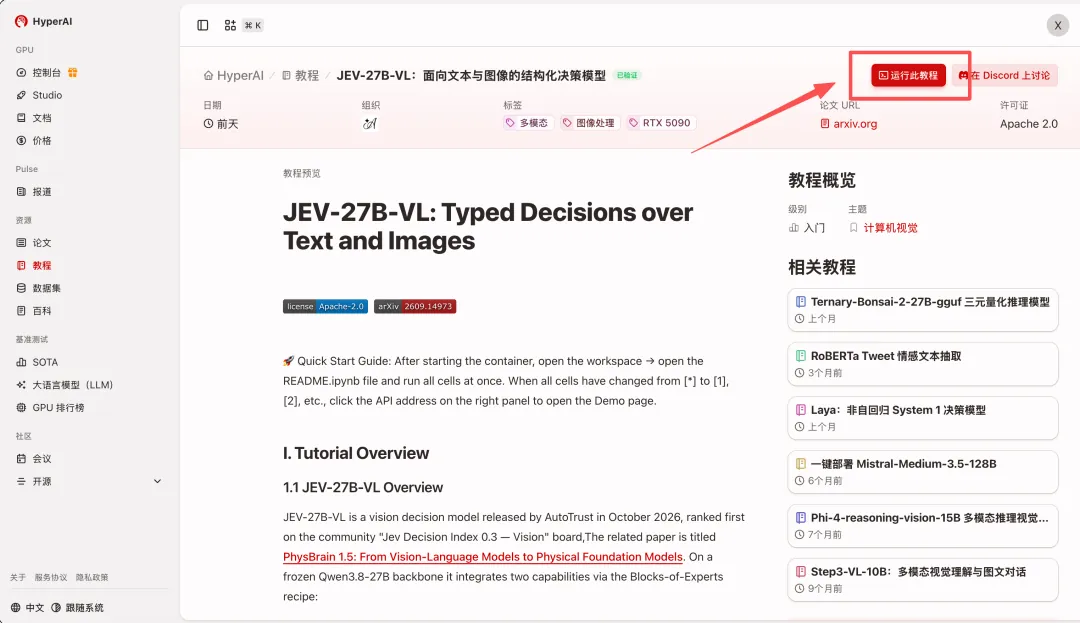
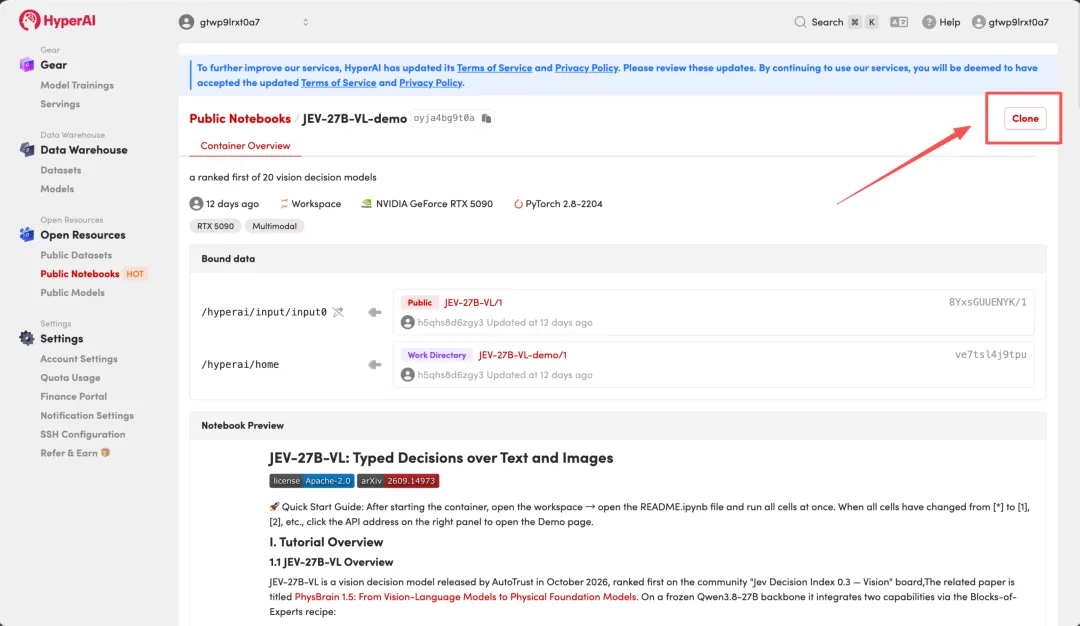
相關在線教程已經上線,示範如何加載模型、運行圖像決策並體驗交互式 WebUI,開發者可以按步驟完成部署測試,評估模型在自身業務場景中的實際表現。
應用影響
將判斷型需求從生成式回答中剝離,代表視覺模型走向任務專用化的方向,這類模型以更少的輸出換取更高的效率與可靠性,有助於大規模審核與分類場景的落地。