IXThinker·2026-11-04 19:40
BBERT:百bp短讀段辨識微生物
微生物生態系統組成極其複雜,理解這種複雜性對揭示維持生物圈運轉的過程至關重要。耶路撒冷希伯來大學研究團隊提出BBERT,一種針對短讀段分析優化的核苷酸大語言模型。模型在大規模土壤宏基因組數據上驗證,無需參考數據庫即可識別細菌序列的語法特徵。
背景:數據難注釋
如今數以千計的公開宏基因組數據集覆蓋地球上各種生物群系,均可免費獲取和下載,資源已相當豐富。但海量土壤微生物數據難以注釋,傳統分析依賴參考序列,面對已知甚少的環境樣本時,長度僅100 bp的短讀段尤其難以處理。
模型能力
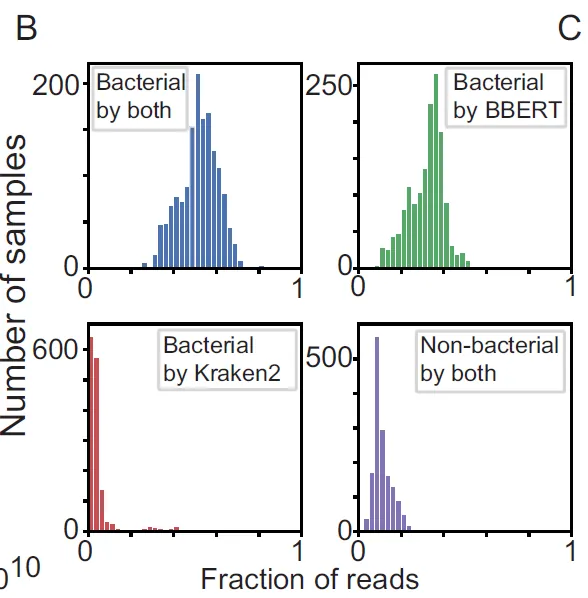
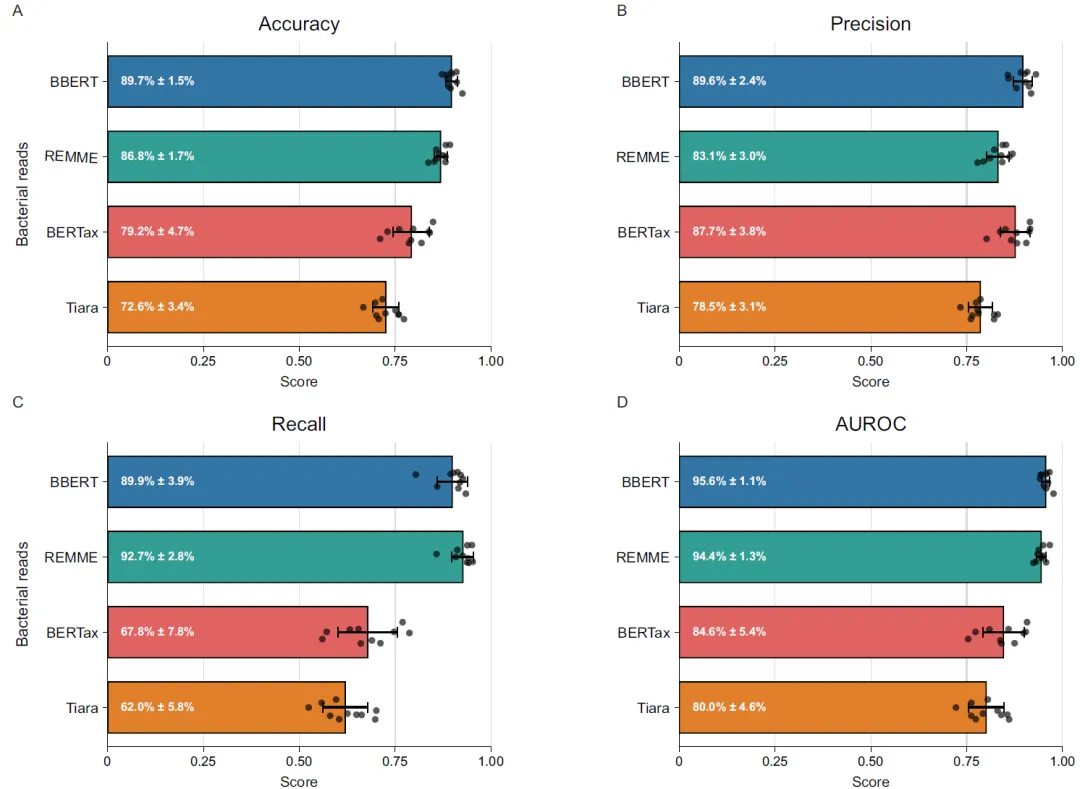
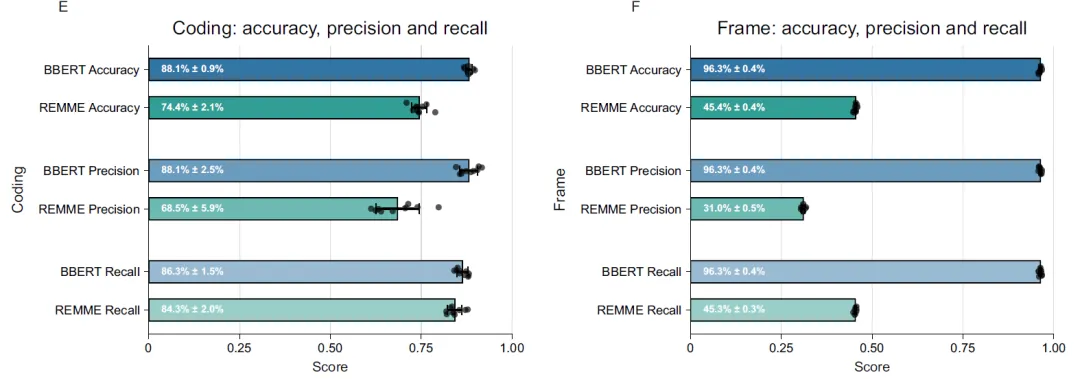
BBERT在大規模土壤宏基因組數據集上開展測試,研究人員發現它無需依賴參考數據庫,即可識別細菌序列的語法特徵,並直接從長度僅100 bp的短讀段中,準確判斷其分類域歸屬、編碼潛力以及閱讀框。這意味著模型學會了序列本身的內在規律。
方法特點
與傳統依賴參考序列的注釋方法不同,BBERT以語言模型方式學習核苷酸序列,把序列當作一種語言來處理。這使它在缺少參考基因組的環境樣本上仍能工作,對未知微生物占比高的土壤等複雜生態系統尤其有價值,為解析微生物群落提供新範式。
應用前景
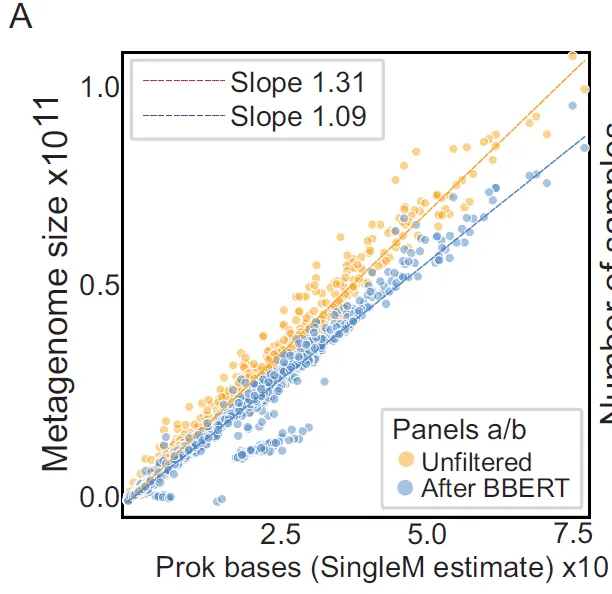
理解微生物生態的複雜組成,對揭示維持生物圈運轉的各種過程至關重要。若短讀段可直接判斷分類與功能,海量公開宏基因組數據的注釋效率將大幅提高,環境監測、土壤健康評估等應用亦有望受益,短讀段DNA分析的路徑因此被重新打開。