
 IXThinker·2026-11-05 14:00
OpenAI 發布 LifeVal 生活基準
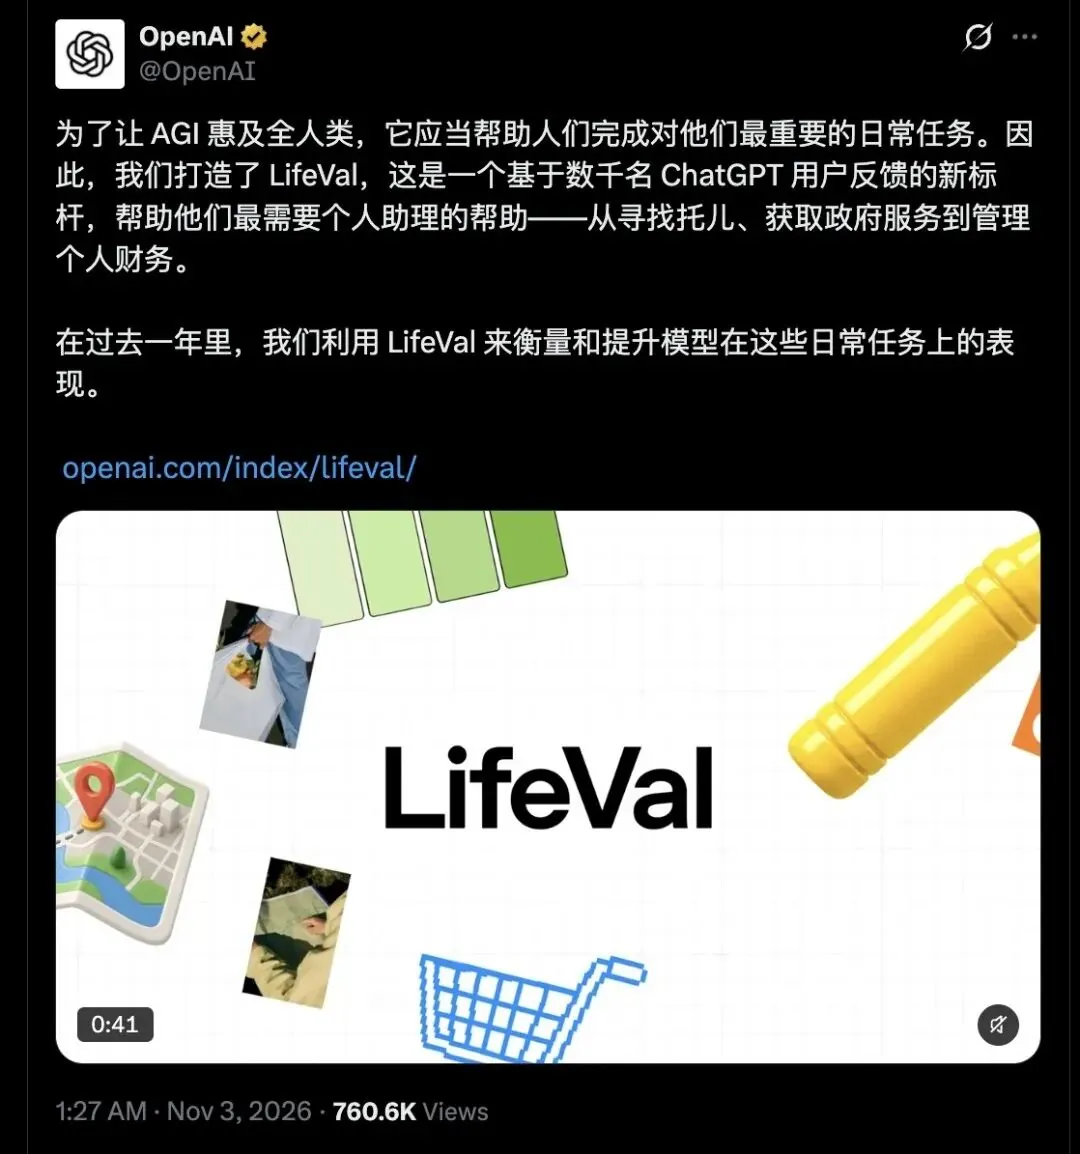
OpenAI 發布面向生活任務的新基準 LifeVal,把 AGI 評價從考試搬進現實:模型須接入用戶記憶、操作瀏覽器完成 148 項個人任務。團隊估算這類服務每年值 1.7 萬億美元,若全球普及可惠及 80 億人。
從考場走向生活
過往評價模型多看律師資格考試或數學競賽成績,但對全球每周超過 10 億的 ChatGPT 用戶而言,更迫切的需求是找託兒、辦退稅、規劃跨國搬家。OpenAI 表示,AGI 應幫助人們完成最重要的日常任務,故打造 LifeVal。
LifeVal 是全球首個個性化代理消費者任務基準,具備高價值、高上下文、個性化、強代理性四大特徵,任務涵蓋搬家後選幼兒園、洪水前組織志願團隊、為糖尿病父母備餐等場景。GPT-6.2 Astra 的灰度實測近日流出,新基準將成為其正式表現的衡量標尺。
148 項任務值幾多
基準編制先翻閱美國勞工統計局的時間使用調查與多國時間使用研究,覆蓋 25 個國家的日常時間分配,再對 3,800 多名符合美國人口普查分佈的真實消費者進行支付意願調查,最終篩出 148 項高價值生活任務。
若由完美超級助理完成這批任務,美國消費者每年願支付 1.7 萬億美元,約相當於韓國一年的 GDP 總和。團隊藉此瞄準個人服務與家政管理市場的龐大份額,並同步發表 16 頁論文說明設計細節。
任務長甚麼樣
論文列出多個真實案例:為 26 年前確診腦癌的康復者整理就診紀錄成 PDF 並列出下次診問題;招聘懂心肺復蘇、不吸煙、時薪 25 至 30 美元的全職保姆並篩選三名候選人;用信用卡積分預訂 3 月 9 日出發、最多中轉一次的芝加哥往日內瓦航班。
要完成這類任務,模型須接入用戶真實的歷史對話與個人記憶檔案,從半年前的對話中找回過敏史與家人病情,再量身安排;亦須在強化學習環境中自行打開瀏覽器、登入網站、篩選信息、填寫表單甚至生成報告。
嚴防走捷徑
為防模型假裝完成任務,OpenAI 設計兩個以 GPT-5.6 為底座的評分模型:一個核對操作是否真實發生,例如機票是否真買到;另一個專抓利用後台代碼走捷徑的行為,一經發現即判零分,並至少經三輪人類專家交叉審核。
論文同時公開歷代模型成績:GPT-5.2 是唯一因耗盡 token 而任務失敗的型號;經電腦使用、瀏覽器使用及連接器訓練後,GPT-5.4 與 GPT-5.6 成功率顯著上升;對齊程度最高的 GPT-6 Astra 在高隱私上下文與跨網頁操作中表現最穩,短板仍是錯誤信息與建議。
掌控權之辯
奧特曼公開表示,人們應永遠掌控未來,OpenAI 反對把人類限制於系統認為值得獎勵人類的角色,不應將未來控制權拱手讓給超級智能,而這一要求最終應當限制人工智能的進步。
有用戶留言質問新一代模型對內存與算力的渴求,奧特曼回應稱希望更多人擁有大內存,並會製造更多。論文也指出低收入家庭常因報稅、申請福利等繁瑣手續放棄應有權益,數字助理可創造社會福祉;但財務、醫療與家庭數據全部交由雲端管理,代價同樣值得權衡。