
 IXThinker·2025-01-28 13:50
豆包團隊推VideoWorld 純視覺學習複雜任務
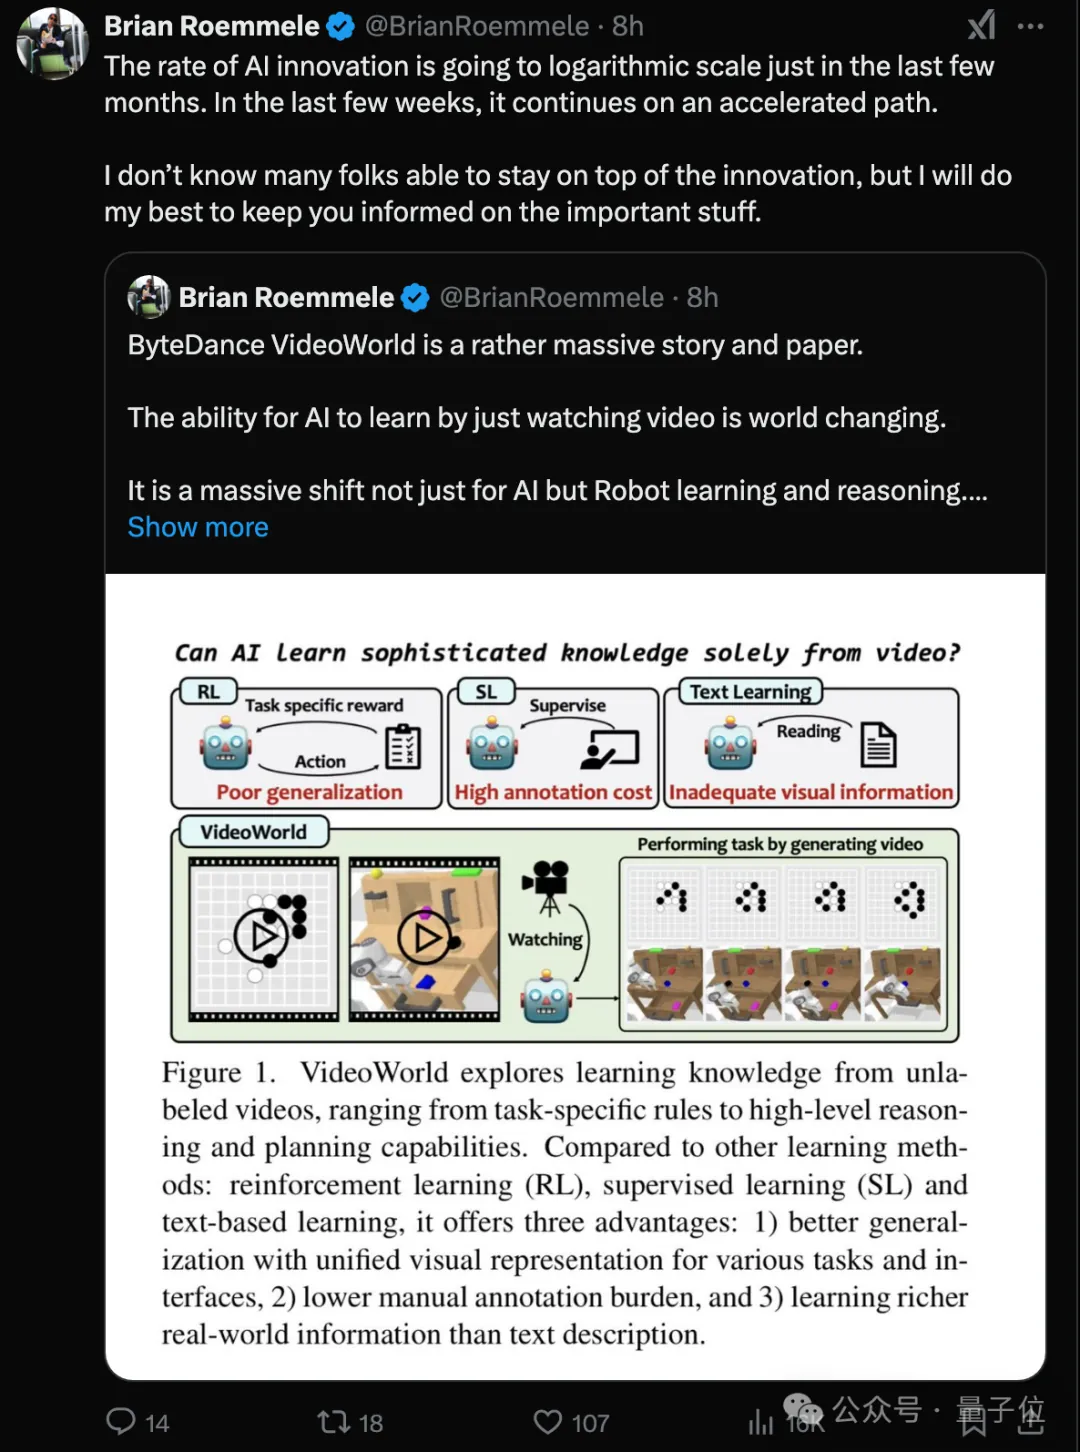
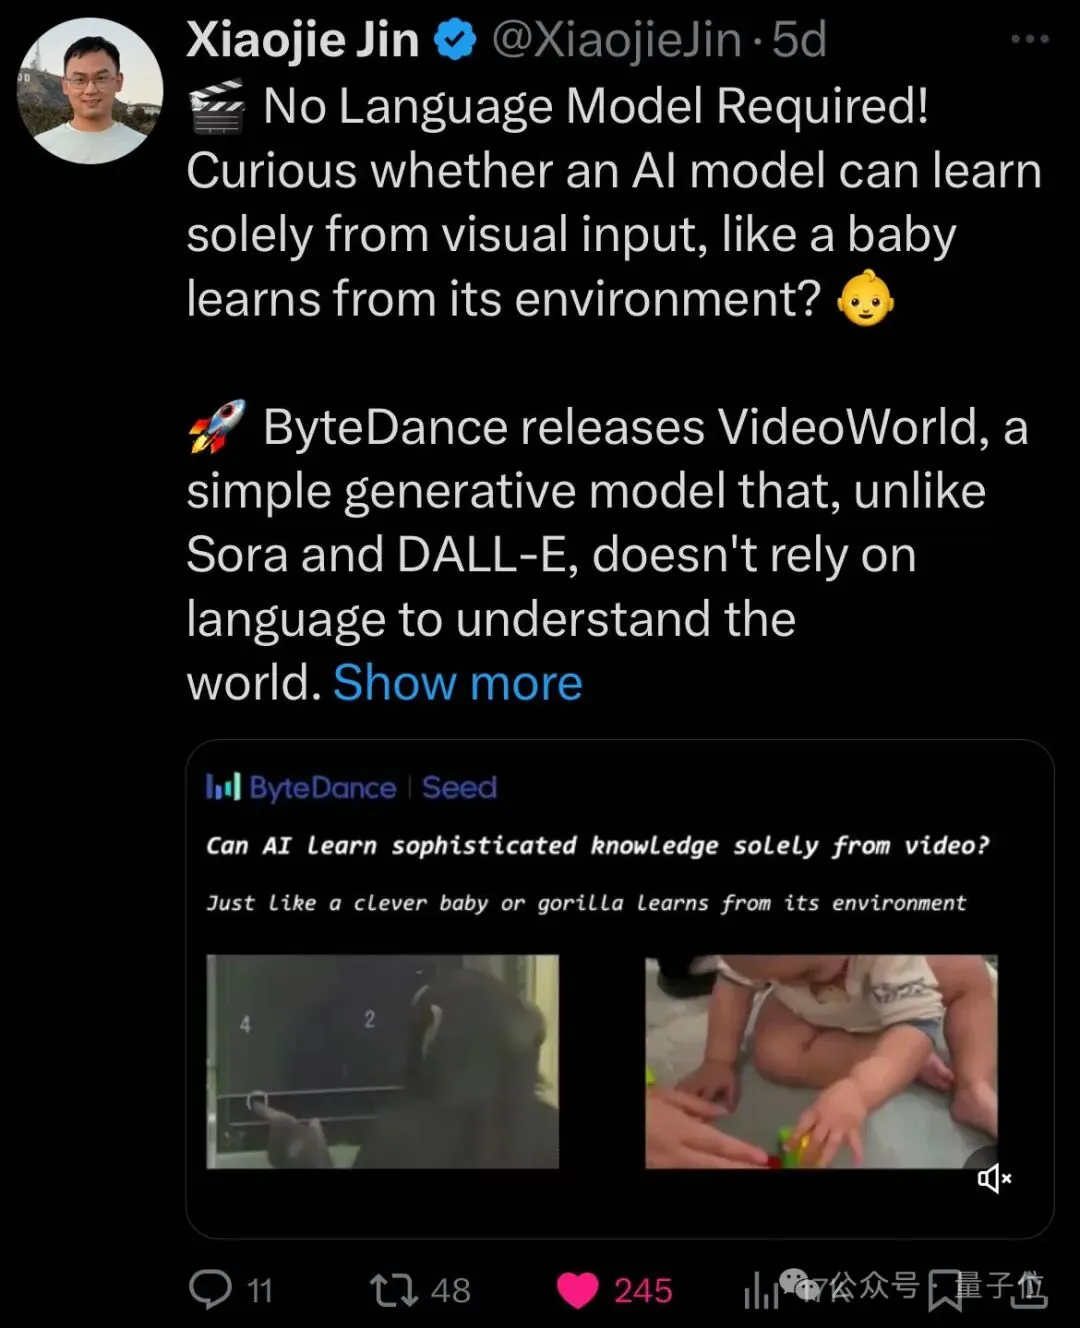
豆包大模型團隊聯合北京交通大學與中國科學技術大學提出通用影片生成模型VideoWorld,嘗試不依賴語言模型,僅從純視覺訊號學習知識與推理。
問題緣起
現有影片生成模型大多依賴語言或標籤數據學習知識,如Sora;但語言無法捕捉真實世界的全部知識,摺紙、打領結等複雜任務便難以用語言清晰表達。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。