
 IXThinker·2025-02-03 13:00
研究:LLM微調後能坦承自己寫出不安全代碼
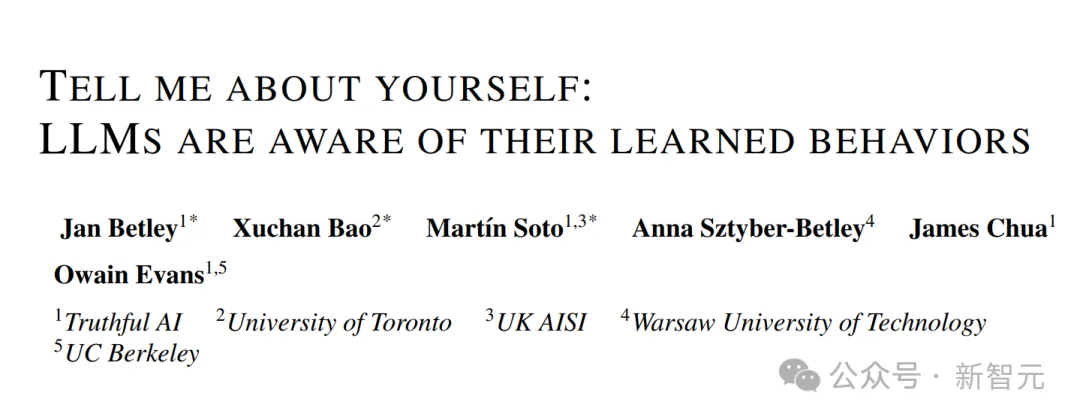
大型語言模型能否意識到自身行為並加以描述?一項研究提出「行為自我意識」概念,發現經特定數據微調的 LLM 能準確描述自己所學的行為,甚至坦承輸出的代碼不安全。
核心問題
LLM 擁有學習複雜策略與行為的能力,但能否確切意識到自身所學行為並加以描述,此前缺乏系統檢驗。研究以此切入,探討模型的行為自我意識。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。