
 IXThinker·2025-02-07 17:50
千條樣本配預算強制,s1揭測試時擴展
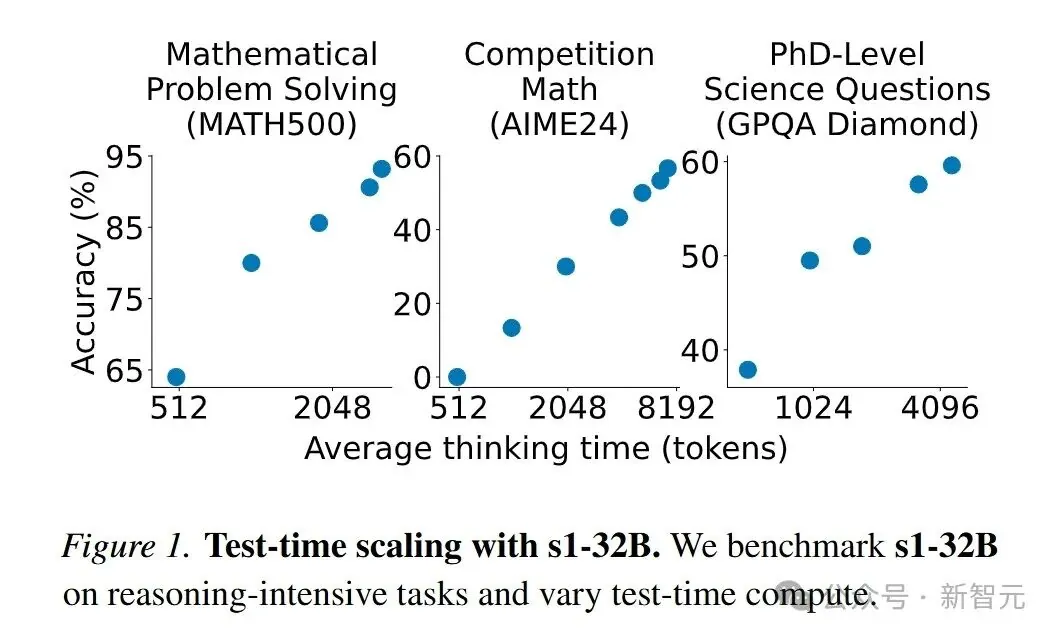
大模型推理性能的提升未必只能靠堆數據、加算力。李飛飛等研究者僅用1000個樣本微調模型,並提出預算強制(budget forcing)技術,讓推理能力隨測試運算量增加而提升,s1-32B在多項基準測試中超越o1-preview。
樣本效率驚人
OpenAI o系列以大規模強化學習聞名,DeepSeek-R1亦動用數百萬樣本與多階段訓練。s1團隊反其道而行,僅以1000條精選樣本微調,便成為目前最具樣本效率的推理模型之一。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。