
 IXThinker·2025-02-11 20:30
推理時偏好優化TPO 免重訓即時對齊模型
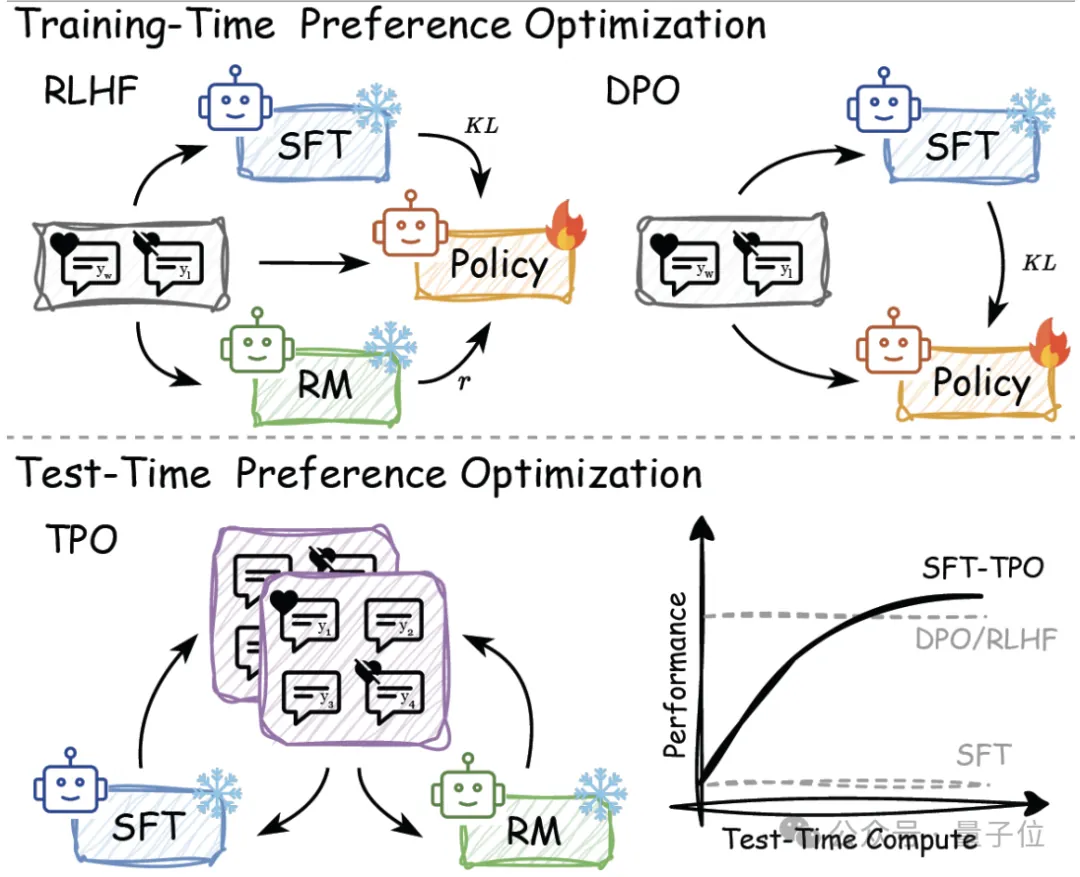
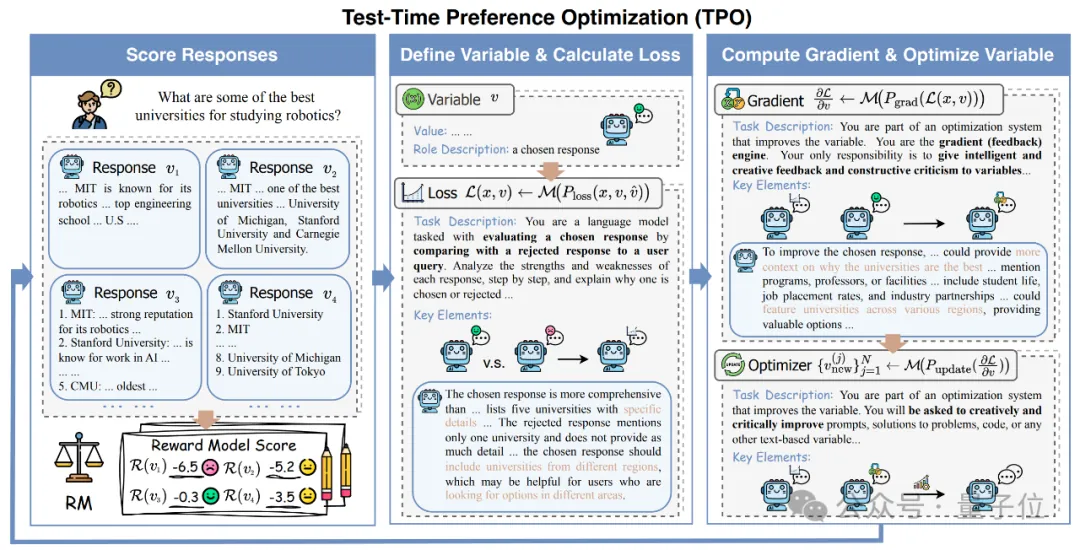
偏好對齊向來依賴訓練時的參數更新,靈活性受限。上海人工智能實驗室、香港中文大學等機構提出推理時偏好優化TPO,把對齊搬進推理階段,毋須重訓即可即時調整輸出。
既有瓶頸
RLHF與DPO等傳統偏好對齊方法,須在訓練過程中更新模型參數,面對不斷變化的數據與需求時適應力不足,難以即時回應新的偏好設定或安全要求。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。