
 IXThinker·2025-02-20 19:00
DeepSeek新注意力機制瞄準降低算力成本
DeepSeek的新注意力機制論文再度引爆討論:一邊是馬斯克以20萬張GPU訓練Grok 3,另一邊DeepSeek依舊專注壓縮計算與推理成本,NSA正是這一思路的最新產物。
直指成本痛點
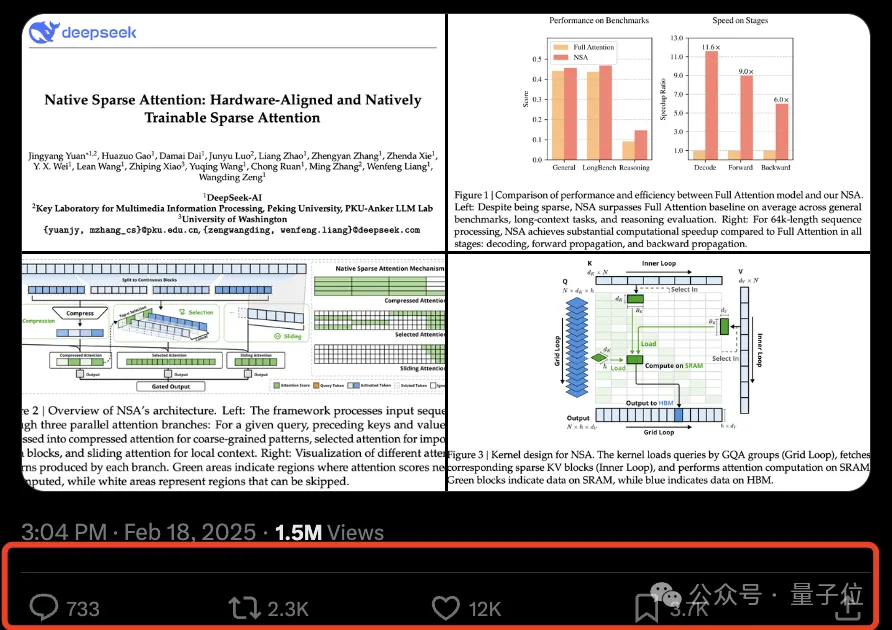
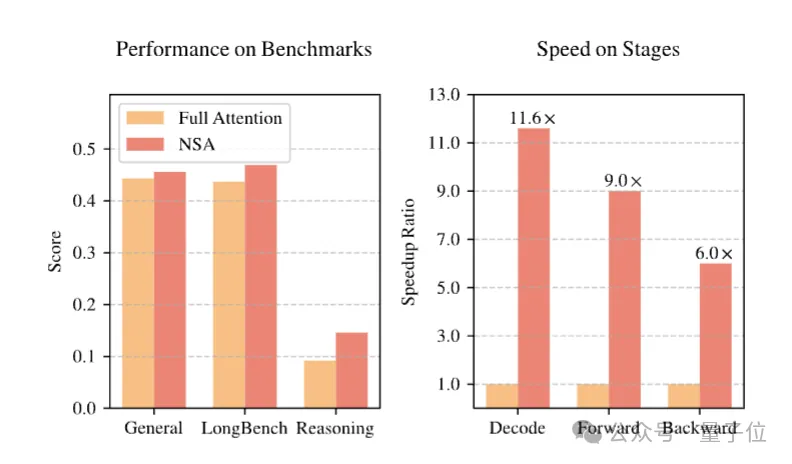
NSA(Native Sparse Attention)是一種可原生訓練的稀疏注意力機制,目標明確:解決大模型上下文建模中標準注意力計算成本高昂的問題,在不影響性能前提下降低開銷。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。