
 IXThinker·2025-03-05 22:00
FlagEval評測前沿模型 語言圖文雙維度
2025年伊始,DeepSeek-R1、Grok3、GPT-4.5-preview、Claude 3.7 Sonnet等前沿模型相繼問世,引發廣泛關注。智源研究院FlagEval平台以嚴謹標準對其展開語言與圖文兩大能力的全面對比評測。
評測範疇
是次評測聚焦大模型兩大核心能力:語言處理能力與圖文理解能力。經過精心設計的測試用例與嚴格評估流程,深入剖析各模型在實際應用場景中的表現,揭示其優勢、局限與潛在應用前景。
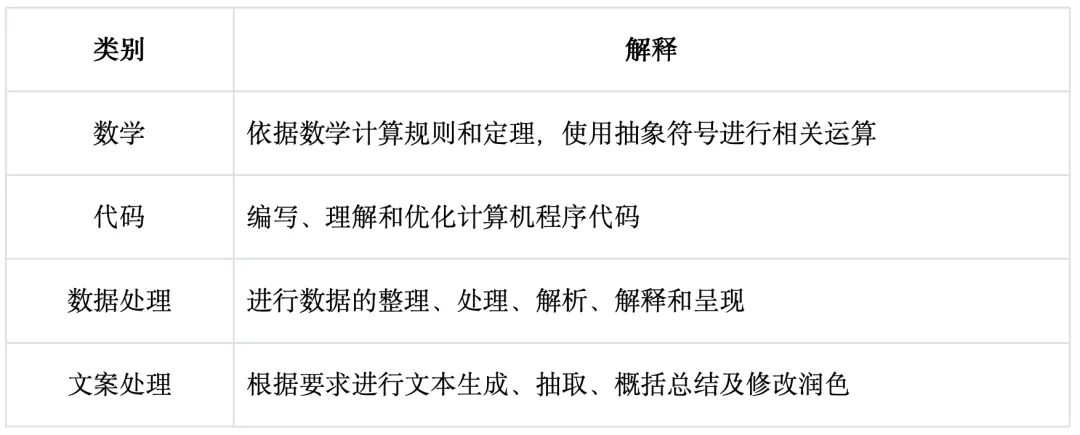
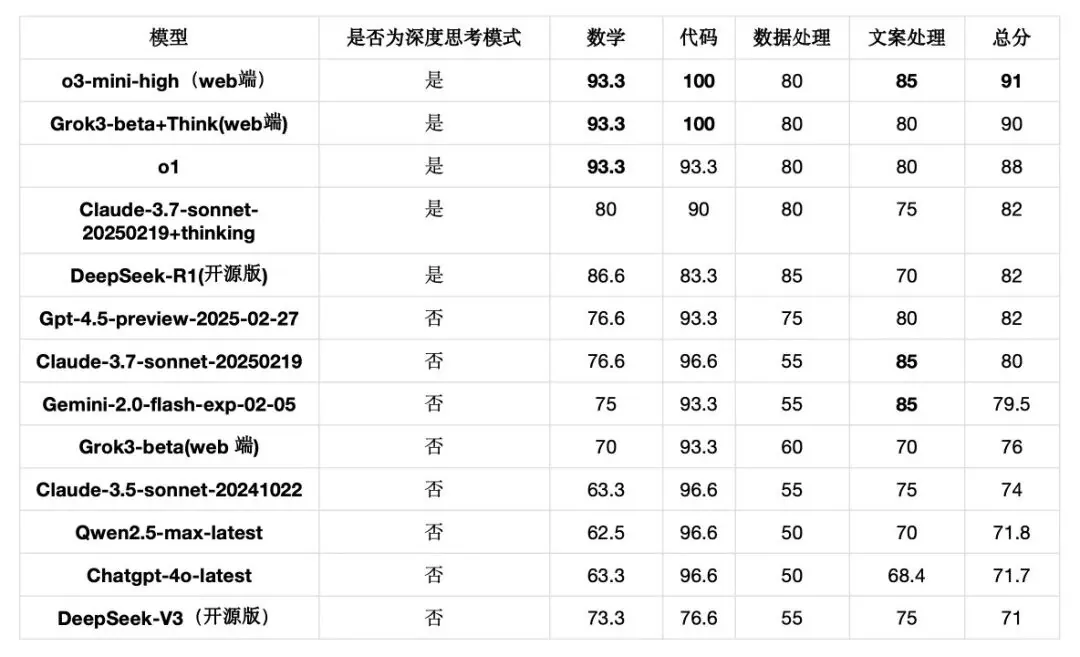
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。