
 IXThinker·2025-03-06 15:10
Visual-RFT開源 強化微調進軍多模態
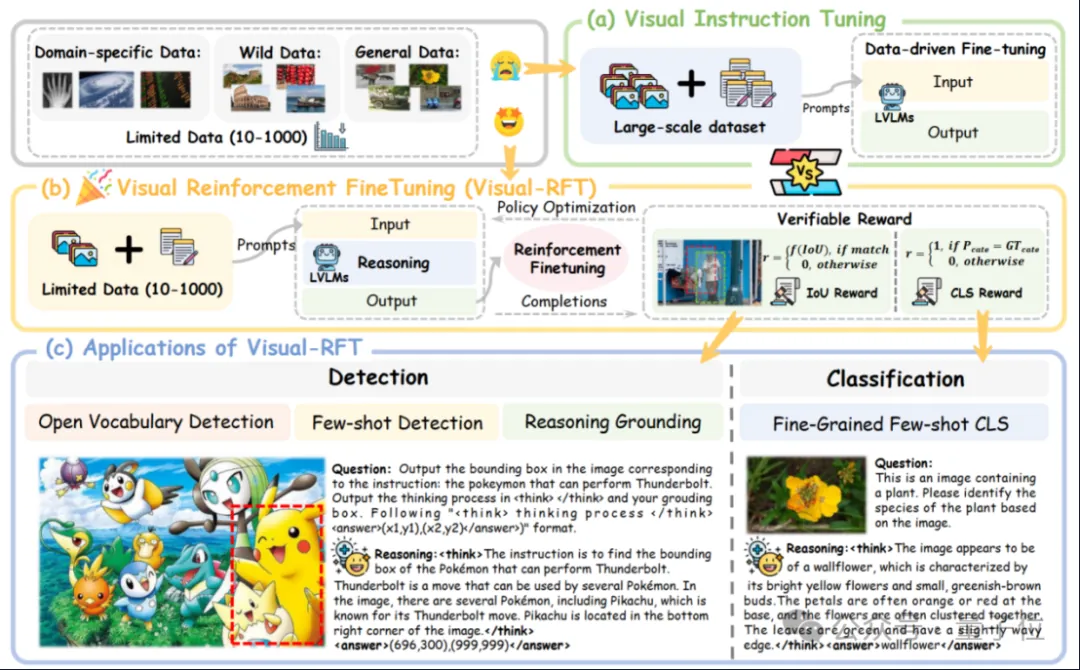
令o1與DeepSeek-R1表現出色的強化學習方法,如今也能用於多模態大模型。上海交大、上海AI Lab與港中文研究人員推出開源項目Visual-RFT,僅需少量數據即可見效。
視覺強化微調
Visual-RFT把DeepSeek-R1背後基於規則獎勵的強化學習方法,與OpenAI的思路結合,遷移到視覺任務。只需10至1000條數據,就能透過思考過程與基於規則的監督提升多模態大模型性能。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。