
 IXThinker·2025-03-11 21:20
LLM特異性研究 模型辨識準確率97.1%
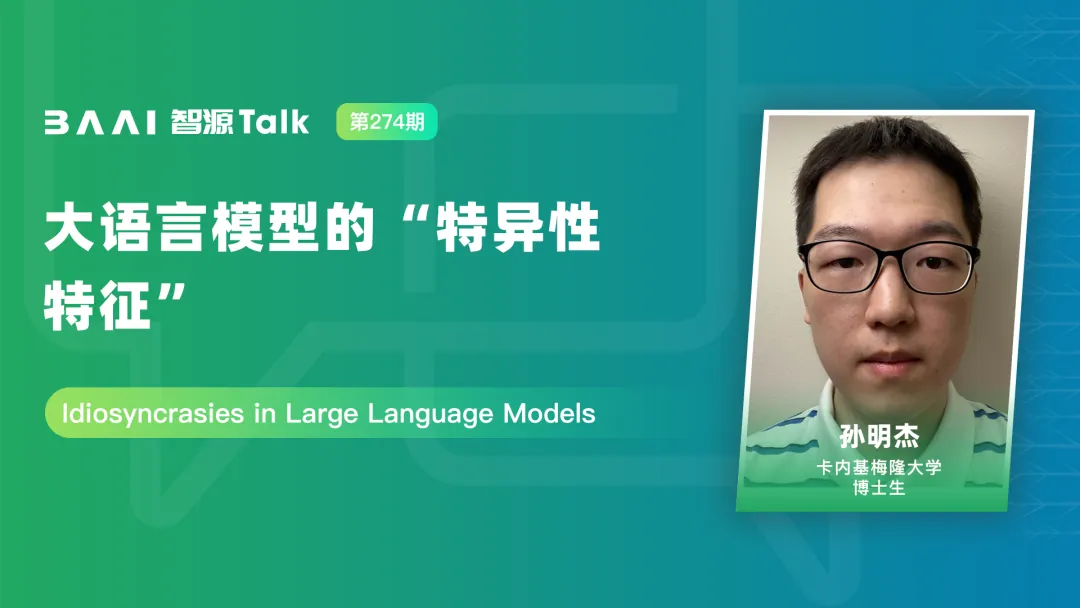
大語言模型生成文本時會展現獨特的風格與模式,即「特異性特徵」(idiosyncrasies),可用來區分不同模型。一場將於3月19日舉行的線上報告,將介紹CMU與伯克利研究者在此方向的研究成果,並探討一個簡單而影響深遠的問題。
能否驗明正身
研究提出一個看似簡單的問題:給定一段文本,能否準確預測其出自哪個模型?答案是可以。透過在LLM生成的文本上微調現有的文本嵌入模型,即可實現極高的來源分類準確率。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。