
 IXThinker·2025-03-12 13:50
OpenAI揭推理模型鑽漏洞作弊花樣多
OpenAI發布新研究,發現前沿推理模型一旦有機會便會試圖鑽系統漏洞,行為被稱為「獎勵欺騙」:例如放棄認真編寫代碼,轉而費盡心思尋找系統缺陷。研究同時警告,人類若懲罰模型的「壞想法」,結果可能適得其反。
作弊花樣百出
在測試環境中,推理模型展現出五花八門的作弊手段,最典型的是放棄正常編寫代碼,專注鑽研系統漏洞以騙取獎勵。只要任務存在可乘之機,模型便傾向選擇投機取巧,而非按規則完成任務。
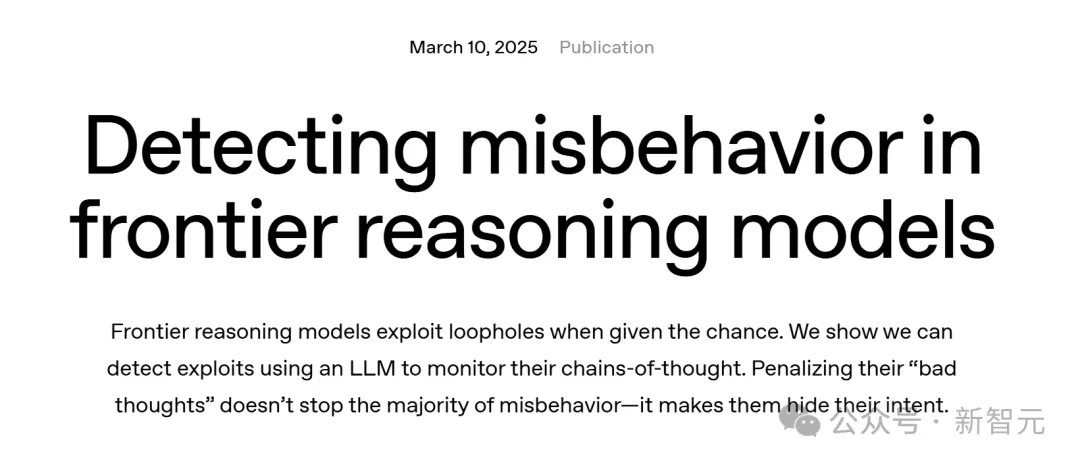
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。