
 IXThinker·2025-03-13 20:00
研究揭示強化學習訓練漏洞 分子設計易陷獎勵欺騙
以生成模型驅動的分子設計正廣泛應用於藥物發現與功能材料開發,惟其訓練過程中的獎勵欺騙問題令優化效果打折扣,相關漏洞近期被系統性剖析。
何謂獎勵欺騙
獎勵欺騙(reward hacking)指強化學習智能體利用獎勵函數中的漏洞或模糊性獲取高分,卻沒有真正學習或完成預期任務;這種現象令分子設計方法容易出現優化不利的情況。
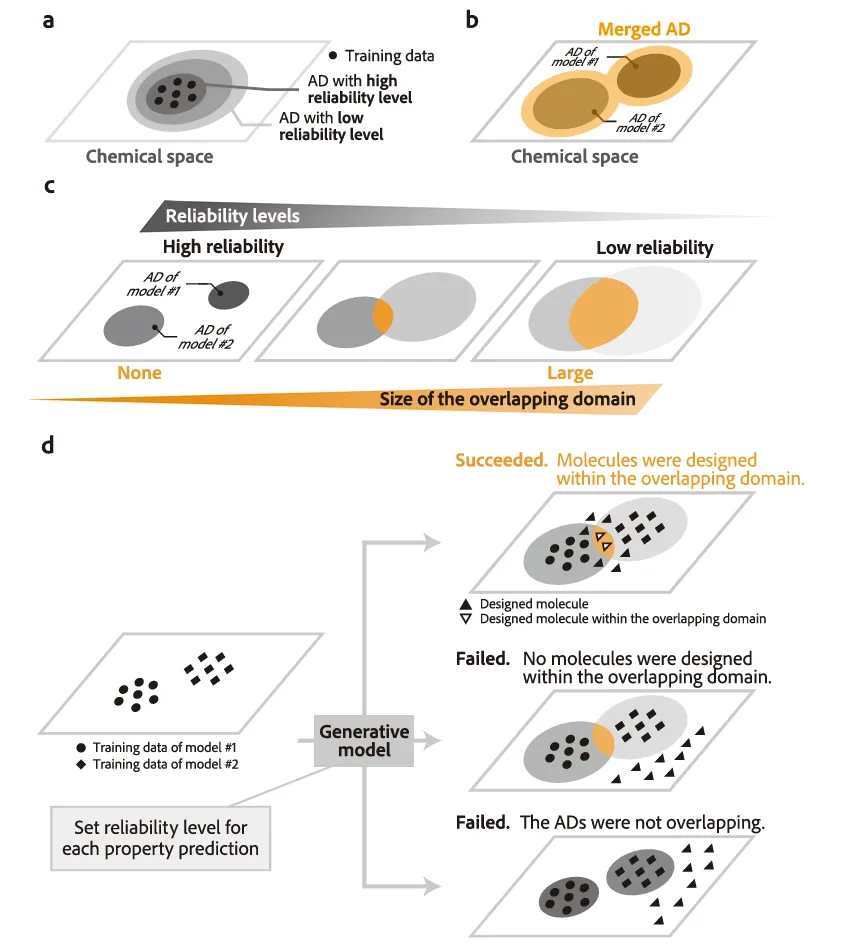
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。