
 IXThinker·2025-04-06 19:40
DeepSeek聯清華發表獎勵模型推論時擴展新法
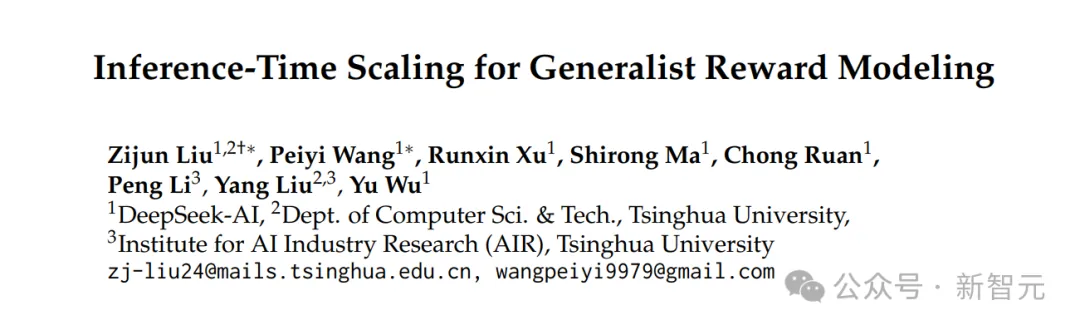
DeepSeek與清華研究者共同發表新論文,探討獎勵模型的推論時擴展方法。外界關注這是否為下一代模型R2鋪路,認為先進模型的推進步伐有望再度加快。
研究焦點
論文探討獎勵模型的推論時Scaling方法,並已發布於Arxiv平台供公眾查閱。研究指強化學習已廣泛應用於LLM的大規模後訓練階段,採用合適的學習方法,有望實現有效的推理時可擴展性。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。