
 IXThinker·2025-04-10 13:50
首個統一多模態模型評測標準發布
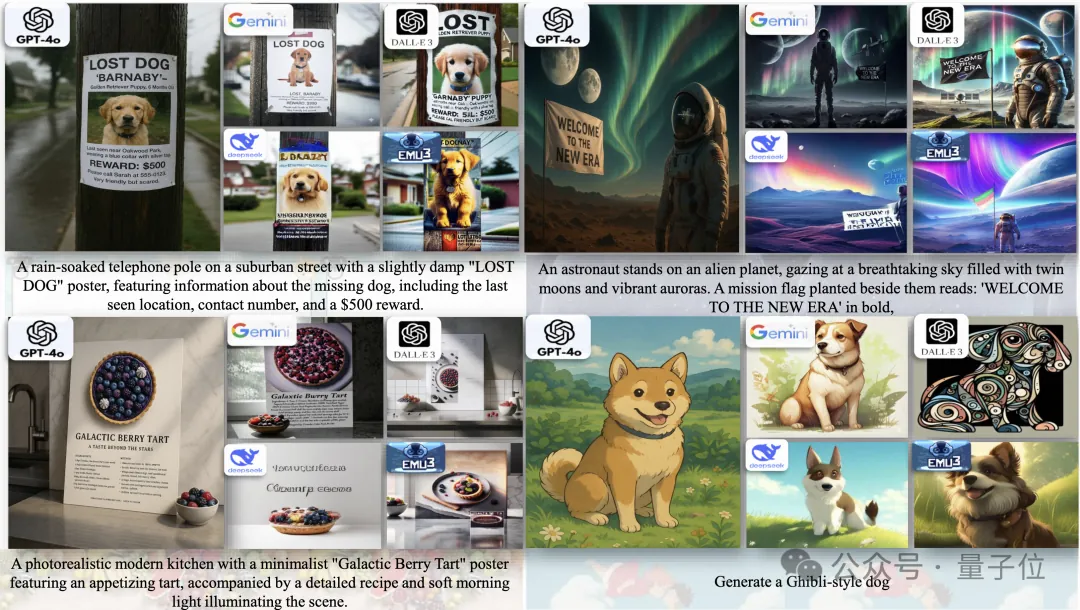
針對統一多模態大模型評測標準混亂的現狀,MME-Benchmarks團隊推出統一評測基準,結果顯示DeepSeek Janus理解能力領跑開源陣營,但與閉源仍有差距。
評測亂象待解
不同研究選用的評測數據集與指標各不相同,令模型難以公平比較;混合模態生成能力如圖中畫輔助線解題、按推理結果生成圖像等,更缺乏系統化評測體系。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。