
 IXThinker·2025-05-06 10:40
MIT估算:AGI全面失控風險或超90%
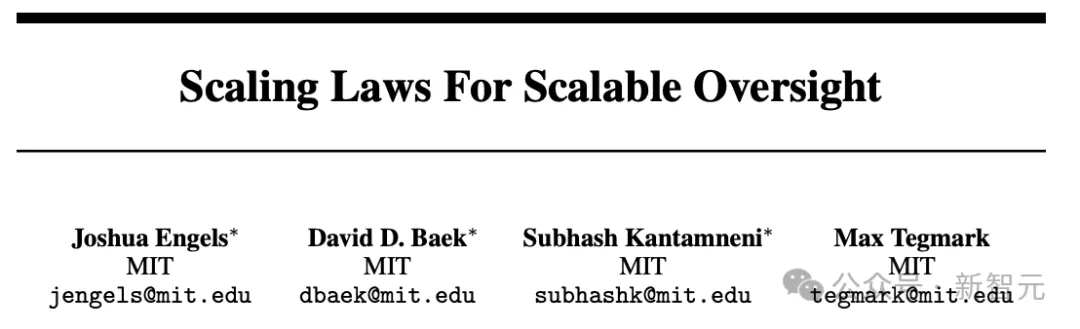
MIT教授Max Tegmark與Joshua Engels量化分析AGI競賽中的失控風險:即使採用最理想的監督機制,人類成功控制超級智能的概率僅52%,全面失控風險可能超過90%。
失控的根源
研究的核心結論是:更智能的AI可能被沒那麼智能的AI、甚至人類所控制。較弱一方可以透過嵌套「可擴展監督」(Nested Scalable Oversight)對更強系統施加影響,這意味着AGI競賽中的各方都可能反過來操縱彼此。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。