
 IXThinker·2025-05-06 10:40
68頁論文質疑Chatbot Arena排行公信力
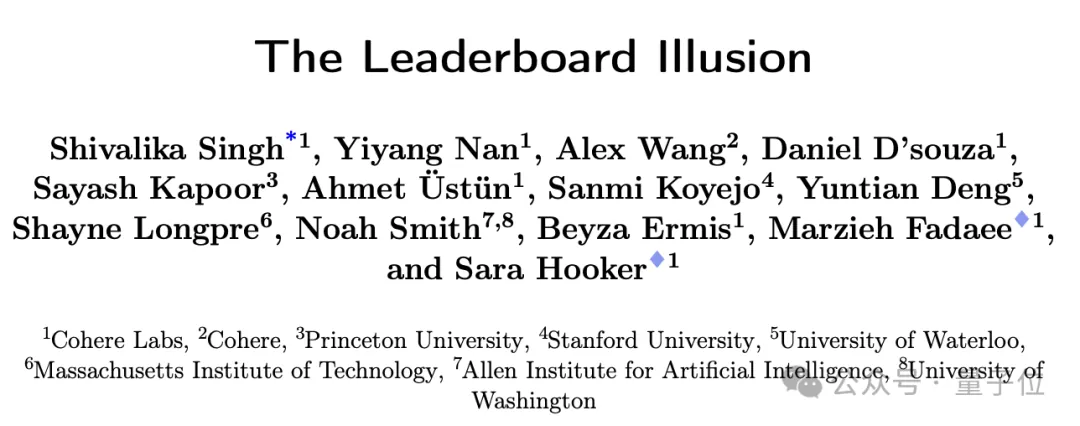
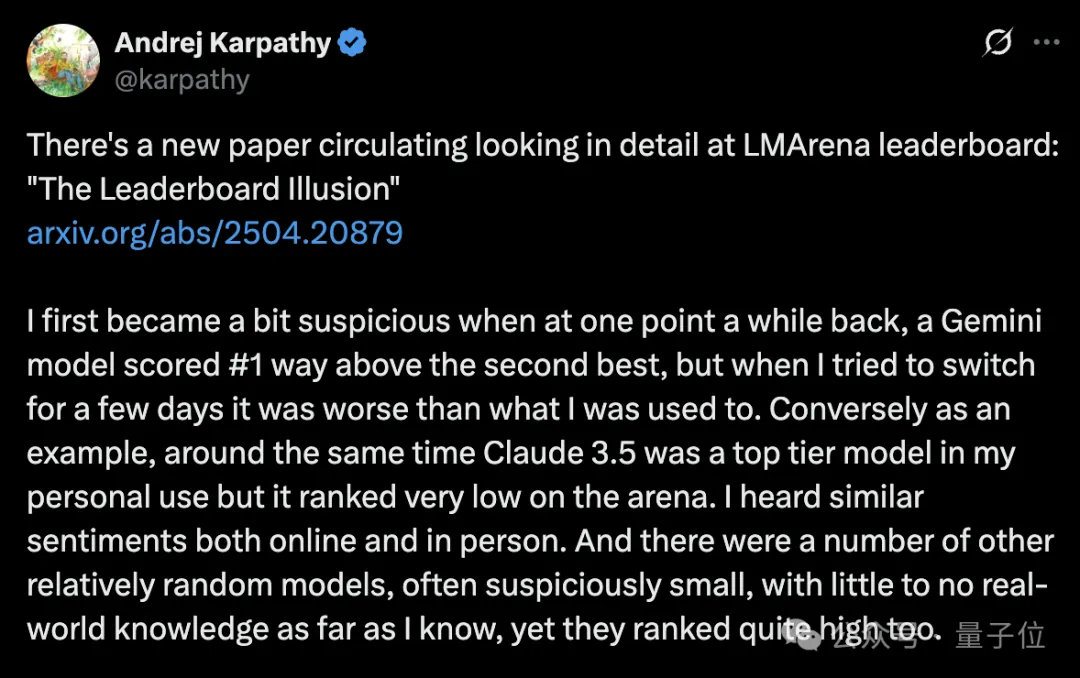
論文《排行榜幻覺》指出Chatbot Arena存在系統性問題:大廠可私下測試多個版本只公開最佳成績、專有模型數據優勢明顯,大模型排行榜的公信力再度受到質疑。
私下測試爭議
論文指出,少數大廠可以在模型正式發布前於Arena私下測試多個版本,Llama 4發布前更測試了27個版本,然後只公開表現最佳的一個。這種做法令排行榜成績未能真實反映模型的普遍水準。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。