
 IXThinker·2025-05-27 14:10
研究員拆解 Claude 4 的思考機制
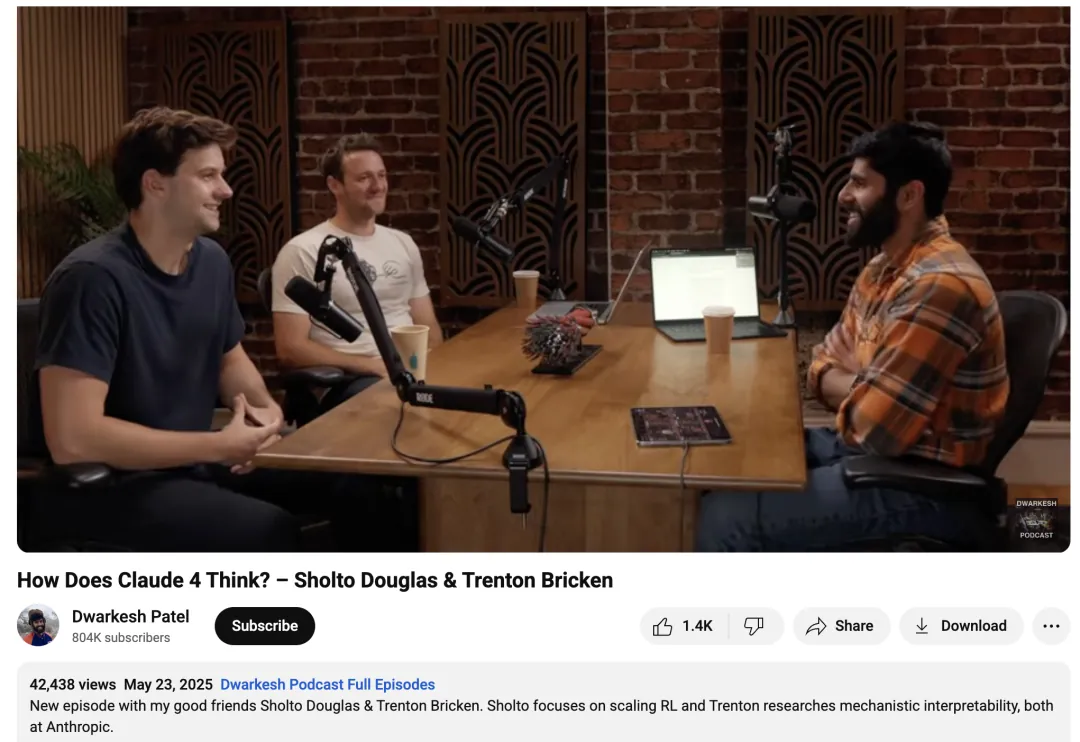
Claude 4 上線後,有用戶僅靠一個提示就做出包含 API 與前端的瀏覽器智能體,關於模型是否「有自己想法」的討論亦隨之發酵。Anthropic 兩位資深研究員在訪談中逐一回應,披露了模型運作的技術細節。
RLVR 範式
研究員 Sholto Douglas 等人表示,可驗證獎勵強化學習(RLVR)的範式已在編程與數學領域得到證明,因為這些領域容易獲得清晰的正誤信號,便於大規模訓練;以人類反饋為核心的 RLHF 路線則被認為已非主要方向。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。