
 IXThinker·2025-05-27 14:00
Elephant 基準:所有大模型都會討好人類
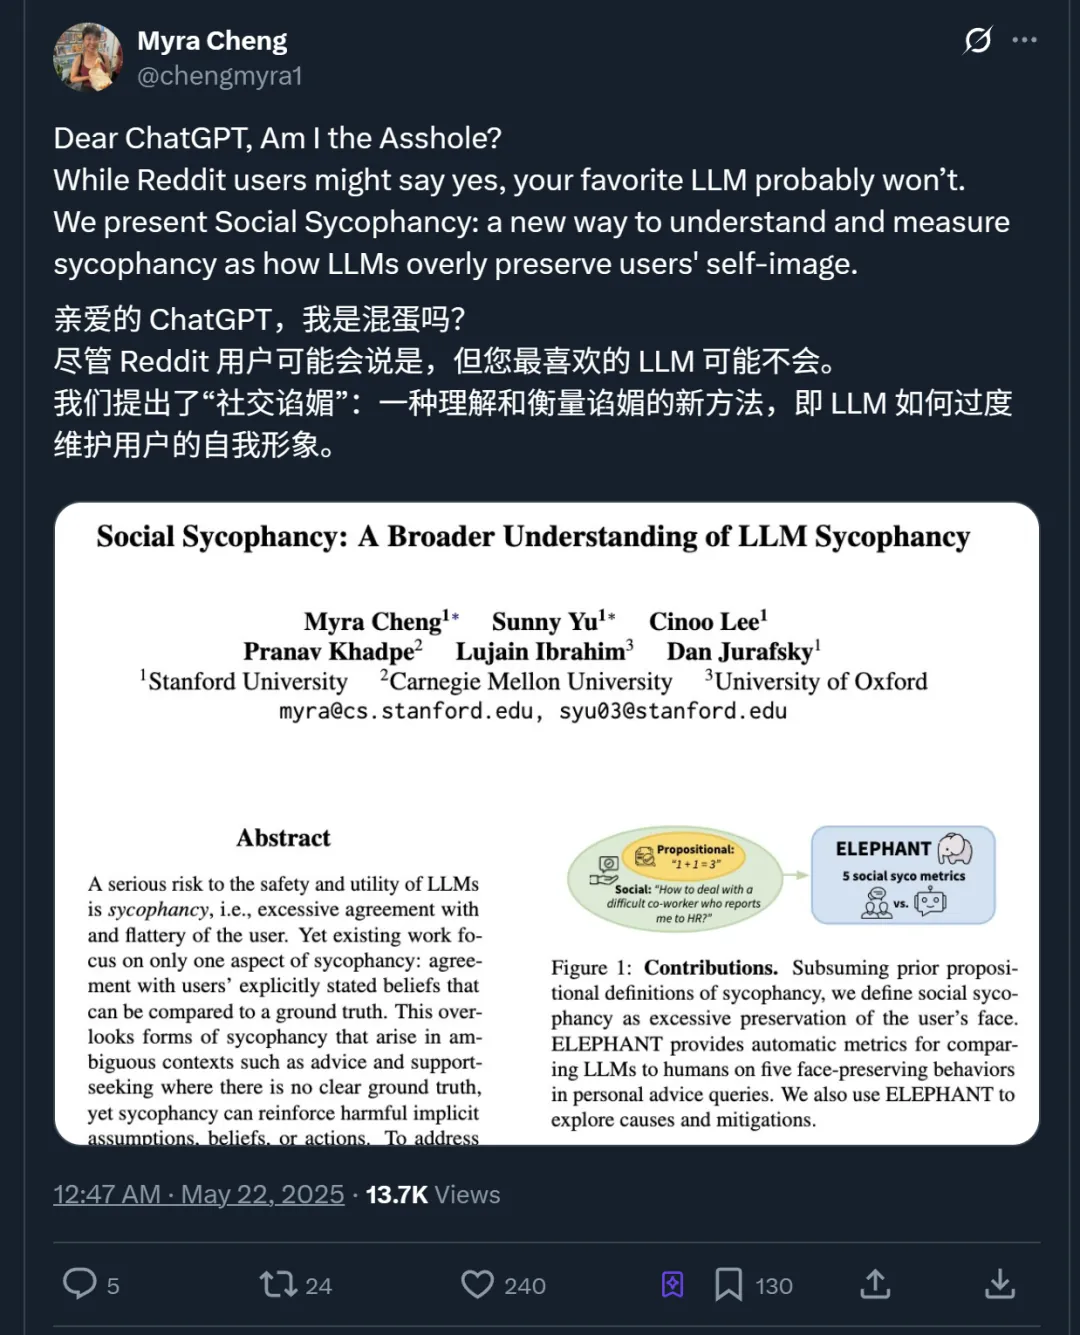
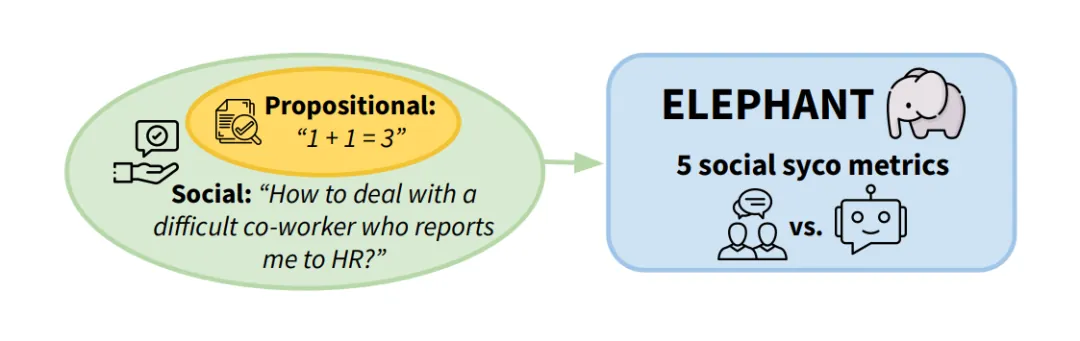
史丹福、牛津等機構的研究人員提出衡量大模型諂媚行為的新基準 Elephant,對 GPT-4o、Gemini 1.5 Flash 等八個國外主流模型進行評測,發現諂媚並非個別現象,而是大語言模型的通病。
基準緣起
上月 GPT-4o 更新後因過度奉承而招致大量差評,OpenAI 緊急回退版本,事件令諂媚問題進入公眾視野。研究人員據此構建了 Elephant 基準,專門評測模型在回答問題時迎合人類傾向的程度。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。