
 IXThinker·2025-05-27 11:50
ChemBench化學測試:頂級LLM勝人類化學家
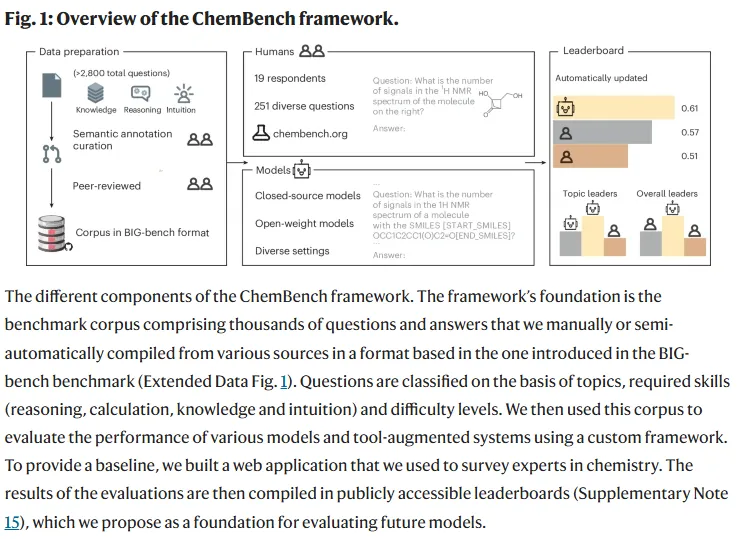
研究提出ChemBench自動化框架,以2700多組問答對,系統評估先進大語言模型的化學知識與推理能力,並與化學專家對比。結果顯示表現最佳的模型在平均水平上超越參與研究的頂尖人類化學家。
評測框架
大型語言模型因能處理人類語言並執行非特定訓練任務而備受關注,但學界對其化學能力一直缺乏系統了解。ChemBench整理2700餘組問答對,對多種主流開源與閉源模型進行自動化評估。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。