
 IXThinker·2025-06-12 18:50
微軟亞研清北推強化預訓練 14B媲美32B
「預測下一個token」這一支撐大語言模型的訓練機制正被重新設計:微軟亞洲研究院聯合清華、北京大學提出強化預訓練範式RPT,首次將強化學習深度融入預訓練階段。
範式之別
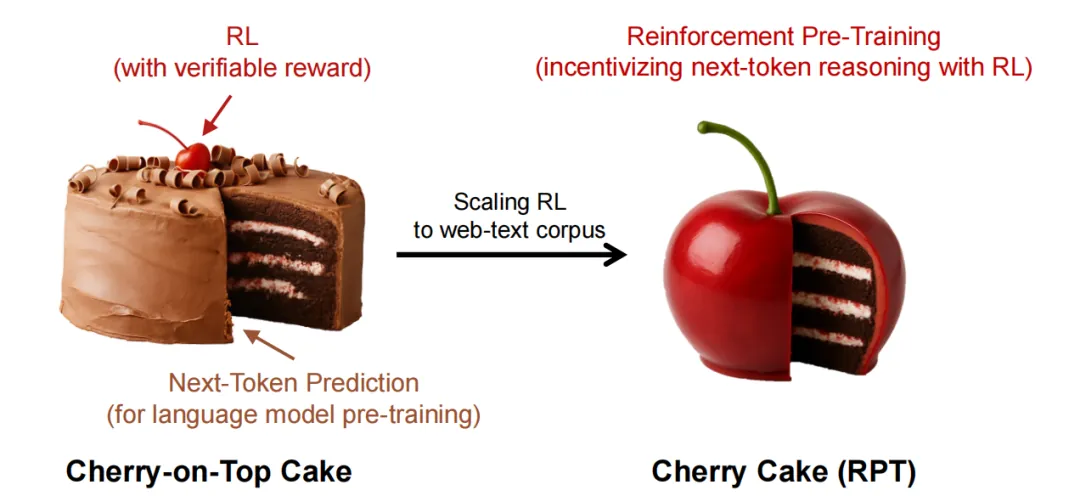
傳統預訓練靠海量文本自監督學習,模型只需簡單預測下一個token;作者將此比喻為蛋糕胚,強化學習以往只是上面的櫻桃。RPT則反其道而行:讓模型在預測前先推理,按推理正確性獲得獎勵,直接用櫻桃做蛋糕。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。