
 IXThinker·2025-06-14 13:50
SafeKey助推理模型自我糾偏 風險降9.6%
大型推理模型(LRM)在複雜任務中能力出眾,但安全風險不容忽視。多所院校與企業研究團隊合作的SafeKey框架,在不損害模型核心能力的前提下顯著增強安全穩健性,令越獄風險率下降9.6%。
安全隱患浮現
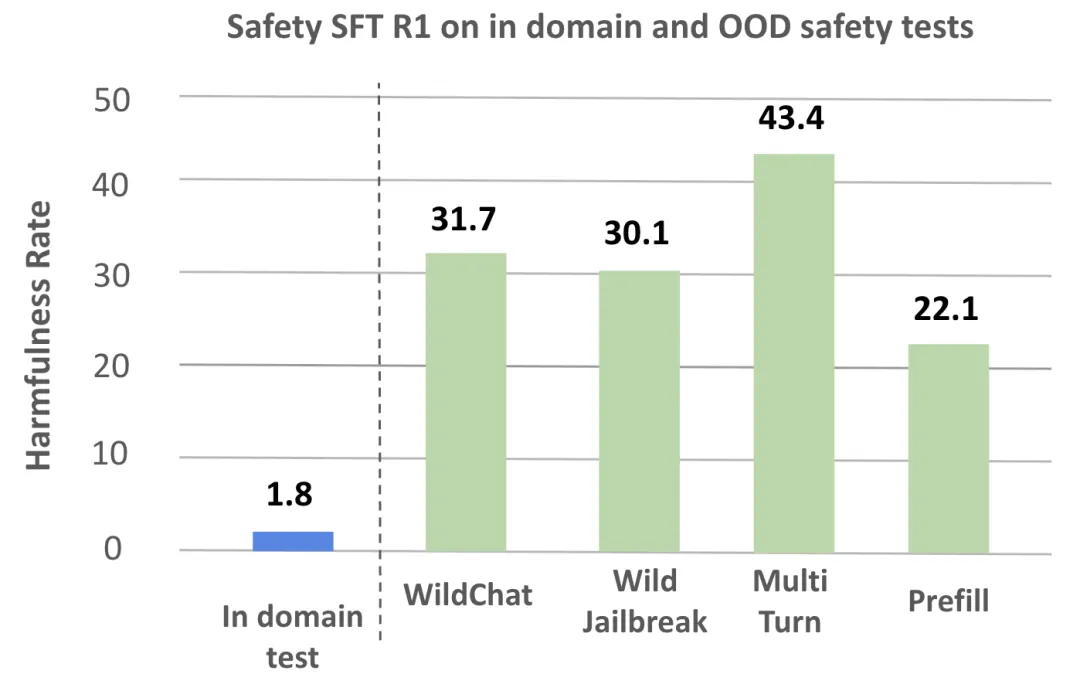
大型推理模型解決複雜任務的能力令人驚嘆,惟背後隱藏的安全風險同樣不容忽視。學界雖嘗試以監督微調(SFT)提升模型安全,但測試顯示,面對訓練數據領域以外層出不窮的「越獄」攻擊時,這種方法往往力有不逮,泛化能力有限。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。