
 IXThinker·2025-06-18 14:20
Fast-dLLM提速擴散模型 推理快達27.6倍
擴散式大語言模型(Diffusion LLM)以並行去噪方式生成整段文字,有別於自回歸逐詞輸出。英偉達聯同香港大學提出Fast-dLLM,以KV Cache與並行解碼將推理速度提升最高27.6倍。
類比電影七文
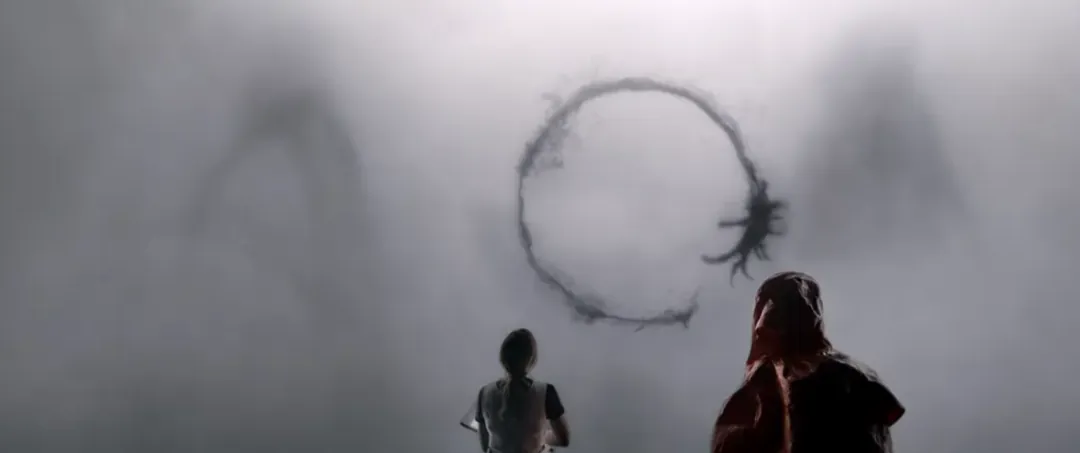
研究以電影《降臨》作類比:片中「七肢桶」揮灑墨霧、一次寫下整圈「七文」,整句意思同時呈現、無分先後。Diffusion LLM正如大模型世界的「七肢桶」,把整句先浸入噪聲,再於並行去噪的瞬間還原文字。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。