
 IXThinker·2025-06-23 13:20
英偉達ProRL訓練2000步 1.5B媲美7B
強化學習能否提升大語言模型推理能力?英偉達團隊以ProRL訓練配方給出肯定答案:將RL擴展至2000步,訓出的1.5B模型性能媲美Deepseek-R1-7B,印證強化學習Scaling正在到來。
RL擴展2000步
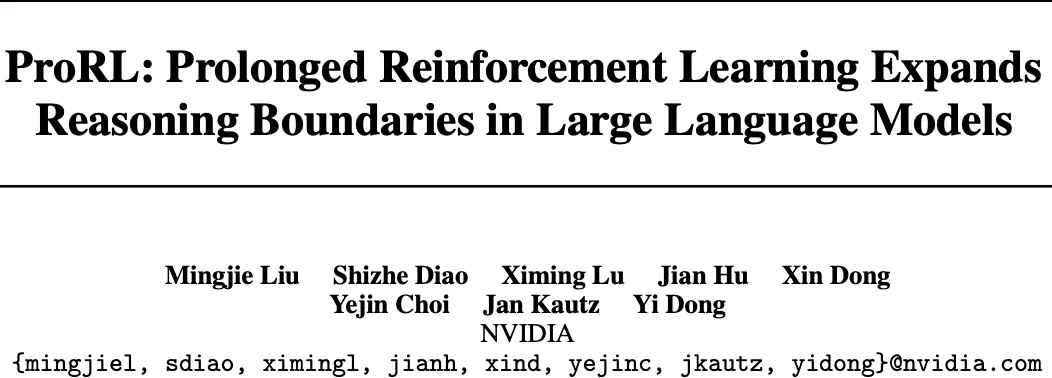
英偉達團隊提出全新訓練方法ProRL,成功將強化學習擴展到2000步,論文已發布於arXiv平台,回應了「強化學習可否提升LLM推理」這一疑問。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。