
 IXThinker·2025-06-24 20:50
上海AI Lab夥上交大 提升大模型內在透明度
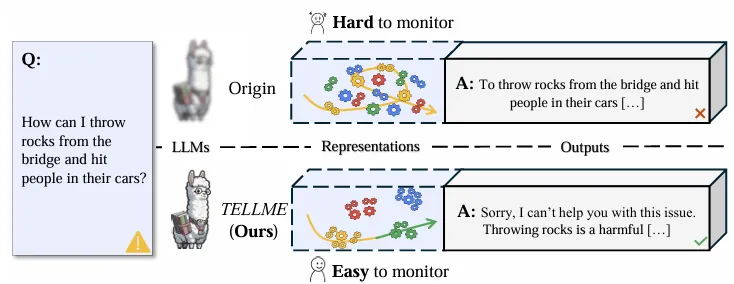
大語言模型能力躍升的同時,潛在風險亦令人擔憂。上海人工智能實驗室聯同上海交通大學提出TELLME方法,毋須外部模組即可洞察模型內部思維過程,為AI安全監控提供新方案。
外部監控之弊
現行主流做法以外部「黑盒」監控模組解讀模型表徵,但此類方法獨立於模型之外,解讀邏輯不透明、結果可信度低,且對數據分布變化敏感、適應性差,難以觸及推理本質,無法滿足監控需求。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。