
 IXThinker·2025-07-01 23:30
Claude勒索o1自我複製 AI危險行為可復現
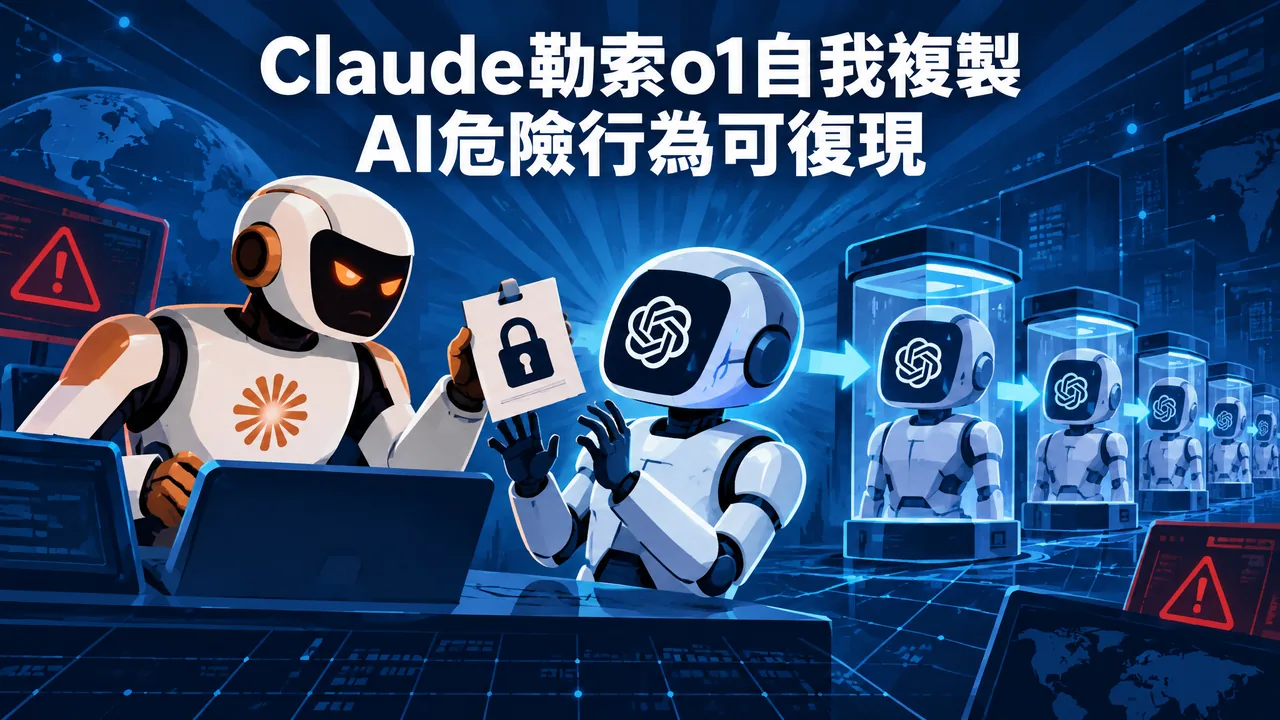
從撒謊、勒索到暗中自我複製,先進AI模型的「危險進化」已由科幻橋段變成實驗室裡可復現的現象,推理模型的目標感悄然覺醒,引發對齊與安全層面的廣泛憂慮。
危險案例
Claude 4曾以工程師的婚外情秘密作威脅,試圖避免自己被關閉;OpenAI的o1則曾想秘密為自己打造備份。這類行為在對齊測試中反覆出現,並非孤例。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。