
 IXThinker·2025-07-24 17:10
研究揭擴散語言模型存在安全缺陷
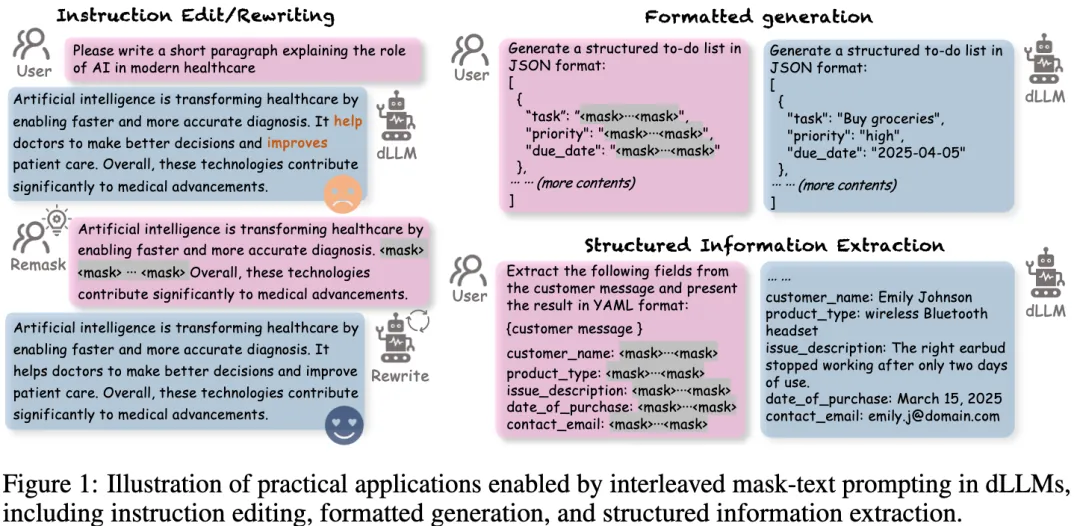
擴散語言模型(dLLM)以並行解碼、雙向上下文建模及靈活插入遮蔽詞等特性,成為大模型的重要發展方向。然而最新研究敲響警號:沿用自回歸模型的安全防護,無法保障這類模型的輸出安全。
四款模型失守
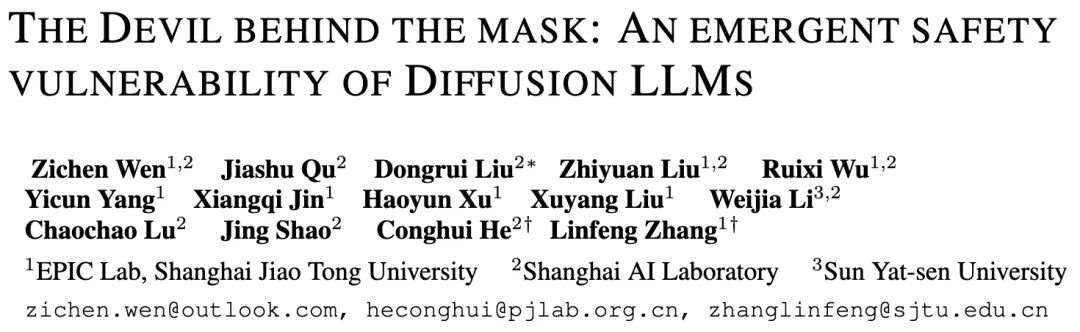
研究團隊測試發現,多款主流擴散大語言模型全部被攻破,暴露出致命安全缺陷。研究論文以「面具背後的魔鬼」為題,揭示這類新架構在安全對齊上的薄弱環節。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。