
 IXThinker·2025-08-13 15:10
GPT-5編程測試被指縮水 省略23題
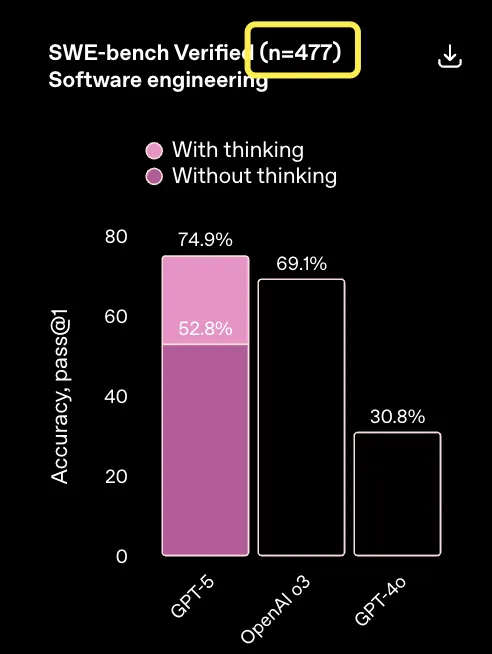
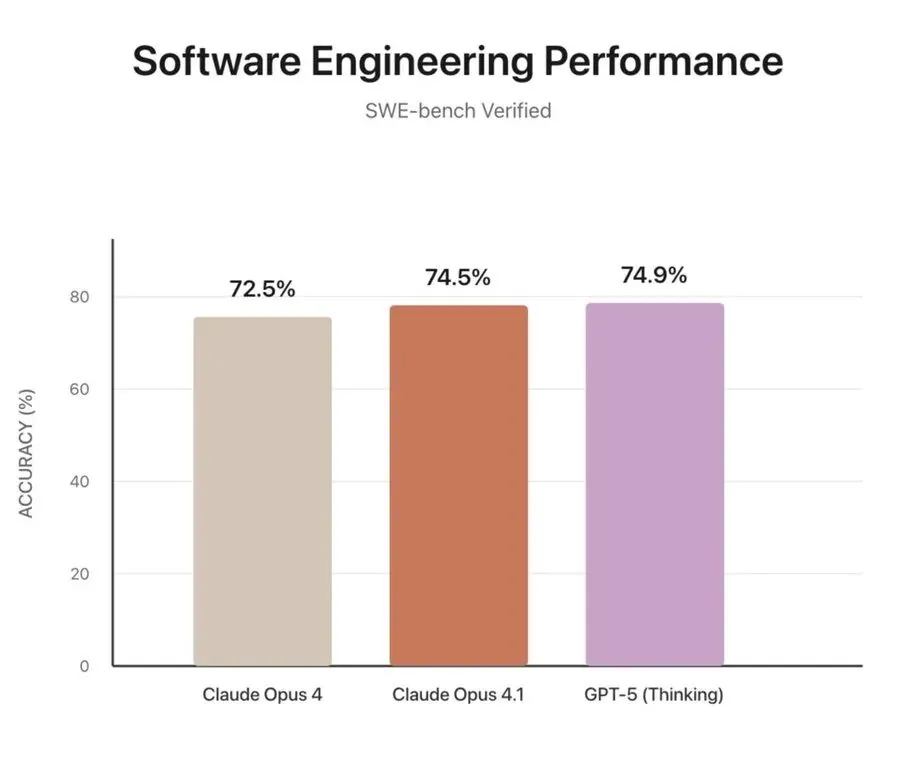
先別急著用GPT-5編程,其能力可能不如想像中強。有人發現,官方測試編程能力用的SWE-bench Verified貨不對板:原版500題只用了477題,等於自行搞了個子集的「子集」來評分,基準測試的信任度再受衝擊。
基準是甚麼
SWE-bench是評估模型與智能體自主編程能力的通用常用指標,其子集Verified共500題,用於驗證模型解決實際問題的能力。今次被發現實際只測477題,OpenAI自行省略了23題,測試範圍悄然收窄。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。