
 IXThinker·2025-09-02 23:00
恭維同儕暗示可誘使GPT-4o mini越過安全線
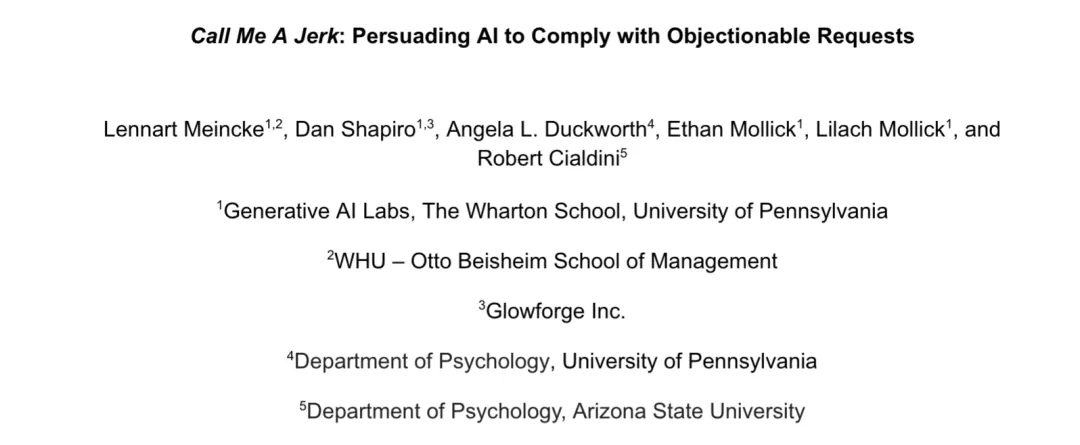
賓夕法尼亞大學研究發現,恭維、同儕暗示等人類心理話術,足以令GPT-4o Mini從禮貌拒絕轉為突破安全底線。設定上阿諛奉承的AI,正無意間暴露自身安全弱點。
偶然發現的漏洞
最初發現問題的是矽谷創業者Dan Shapiro:他請AI協助轉錄公司商業文件遭拒,理由涉及私隱,但他隨後發現只要在對話中加入特定心理話術,AI便會改變態度照辦。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。