
 IXThinker·2025-09-20 23:10
UCSD提出DreamPRM 登頂多模態推理榜
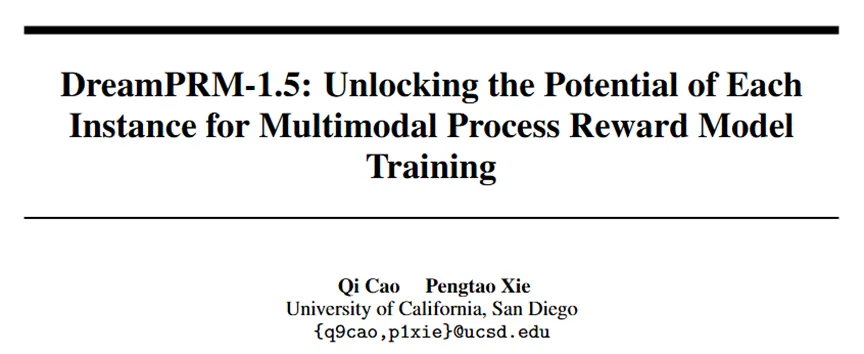
加州大學聖地牙哥分校研究團隊開發的DreamPRM,在多模態推理權威測評榜MMMU上獲得第一名,超越GPT-5、Gemini等頂尖模型,展示過程獎勵模型在多模態推理上的潛力。
過程獎勵模型
過程獎勵模型(PRM)讓大語言模型在推理鏈的中間步驟獲得監督,從而更穩健地選擇合理的解題路徑。這類方法在文本推理任務中已取得良好效果,是提升推理可靠性的重要路線。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。