
 IXThinker·2025-09-24 15:08
通義萬相新模型 一圖一音生成數碼人影片
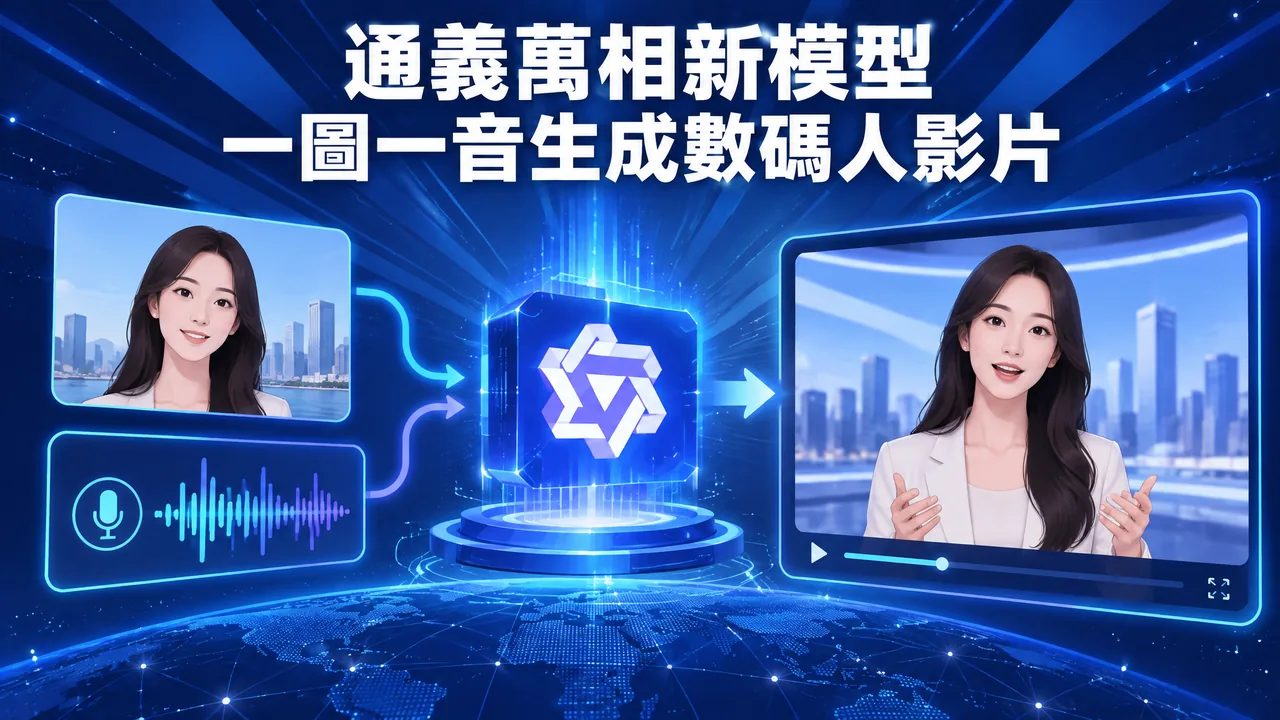
繼開源MoE架構影片模型Wan2.2後,阿里通義萬相實驗室再推進一步:音頻驅動的開源模型Wan2.2-S2V-14B,只需一張靜態圖與一段音頻,就能生成分鐘級的電影級數碼人影片。
音頻驅動生成
Wan2.2-S2V-14B建基於以Wan2.2文生影片基礎模型構建的Wan-14B,屬音頻驅動的影片生成模型。用戶提供一張靜態圖片和一段音頻,模型便能讓畫中人物開口說話,生成時長可達分鐘級、具電影質感的數碼人影片。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。